Die meisten Softwareprodukte entstehen nicht aus einer Idee am Reißbrett. Sie entstehen aus einem Muster, das man irgendwann nicht mehr übersehen kann. Bei uns war es eine Häufung von Anfragen aus einer Richtung, mit der wir nicht gerechnet hatten: Schweizer KMU, die ihre Daten aus bexio endlich vernünftig auswerten wollten.
Dieser Beitrag erzählt, wie aus diesen Anfragen zunächst ein Power-BI-basiertes Produkt wurde, warum dieses Produkt wirtschaftlich an seine Grenzen stieß und wie wir smiit Analytics anschließend als eigene SaaS-Plattform neu gebaut haben. Es geht um Architekturentscheidungen, um Fehler, die man erst mit echten Buchhaltungsdaten findet, und um die Frage, was KI-gestützte Softwareentwicklung in einem anspruchsvollen Projekt tatsächlich leistet und was nicht.
Warum ausgerechnet bexio?
smiit ist im Kern ein Dienstleister für Apps, Workflows und Analytics im Mittelstand. Unser Schwerpunkt lag lange auf Auftragsmanagement und individuellen Geschäftsanwendungen. Eine Software, die ausschließlich in der Schweiz verbreitet ist, stand nicht auf unserem Radar.
Zwischen Ende 2021 und Ende 2025 erreichten uns dann fünf bis sechs Anfragen, die sich konkret auf bexio bezogen. Das klingt nach wenig. Für ein einzelnes Drittsystem, noch dazu eines außerhalb unseres Heimatmarkts, war es für uns aber bemerkenswert viel. Die Anfragen ähnelten sich stark: Die Daten liegen in bexio, das Tagesgeschäft läuft dort gut, aber für Auswertungen über Zeit, über Bereiche hinweg oder für die Steuerung des Unternehmens reicht das Bordmittel nicht.
Im Nachhinein ist das Muster leicht zu erklären. bexio ist in der Schweiz weit verbreitet und meldete im Februar 2026 mehr als 100.000 KMU-Kunden. Diese Unternehmen haben Buchhaltung, Aufträge, Rechnungen, Projekte und Zeiterfassung in einem System. Damit liegen die Daten für ein gutes Controlling bereits vor, sie werden nur selten genutzt. Wer das einmal erkannt hat, sieht in jeder weiteren Anfrage nicht mehr ein Einzelprojekt, sondern einen Markt.[1]
Die erste Antwort: smiit Analytics auf Basis von Power BI
Die naheliegende Reaktion war, das zu tun, was wir ohnehin gut konnten: Power BI. 2024 haben wir aus den bisherigen Projekten ein standardisiertes Produkt gebaut. Es bestand aus einem vollständigen Datenmodell für die bexio-Daten und einer großen Zahl vorgefertigter Auswertungen. Ende 2025 kam es auf den bexio Marketplace.
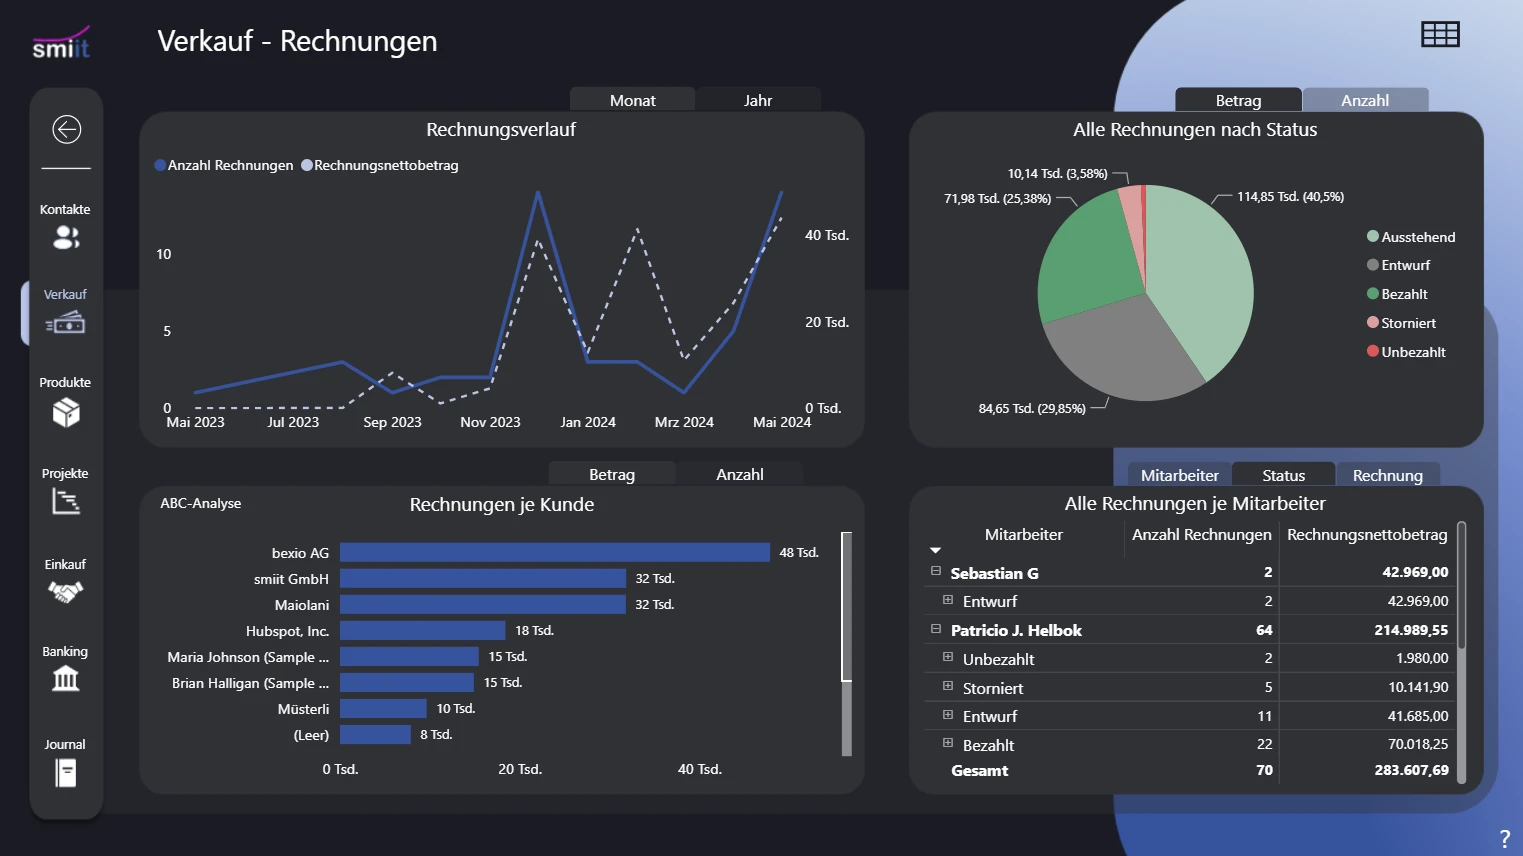
Das Produkt hatte echte Stärken:
- Maximale Flexibilität. Power BI ist ein ausgereiftes Werkzeug. Nahezu jede Auswertung ließ sich umsetzen.
- Datenhoheit beim Kunden. Die Lösung wurde in der Umgebung des Kunden eingerichtet und dort betrieben.
- Schneller Nutzen. Mit den vorgefertigten Berichten war ein Großteil des Standardbedarfs sofort abgedeckt.
Die Schwächen zeigten sich nicht in der Technik, sondern im Geschäftsmodell.
Warum der Einmalpreis zur Falle wurde
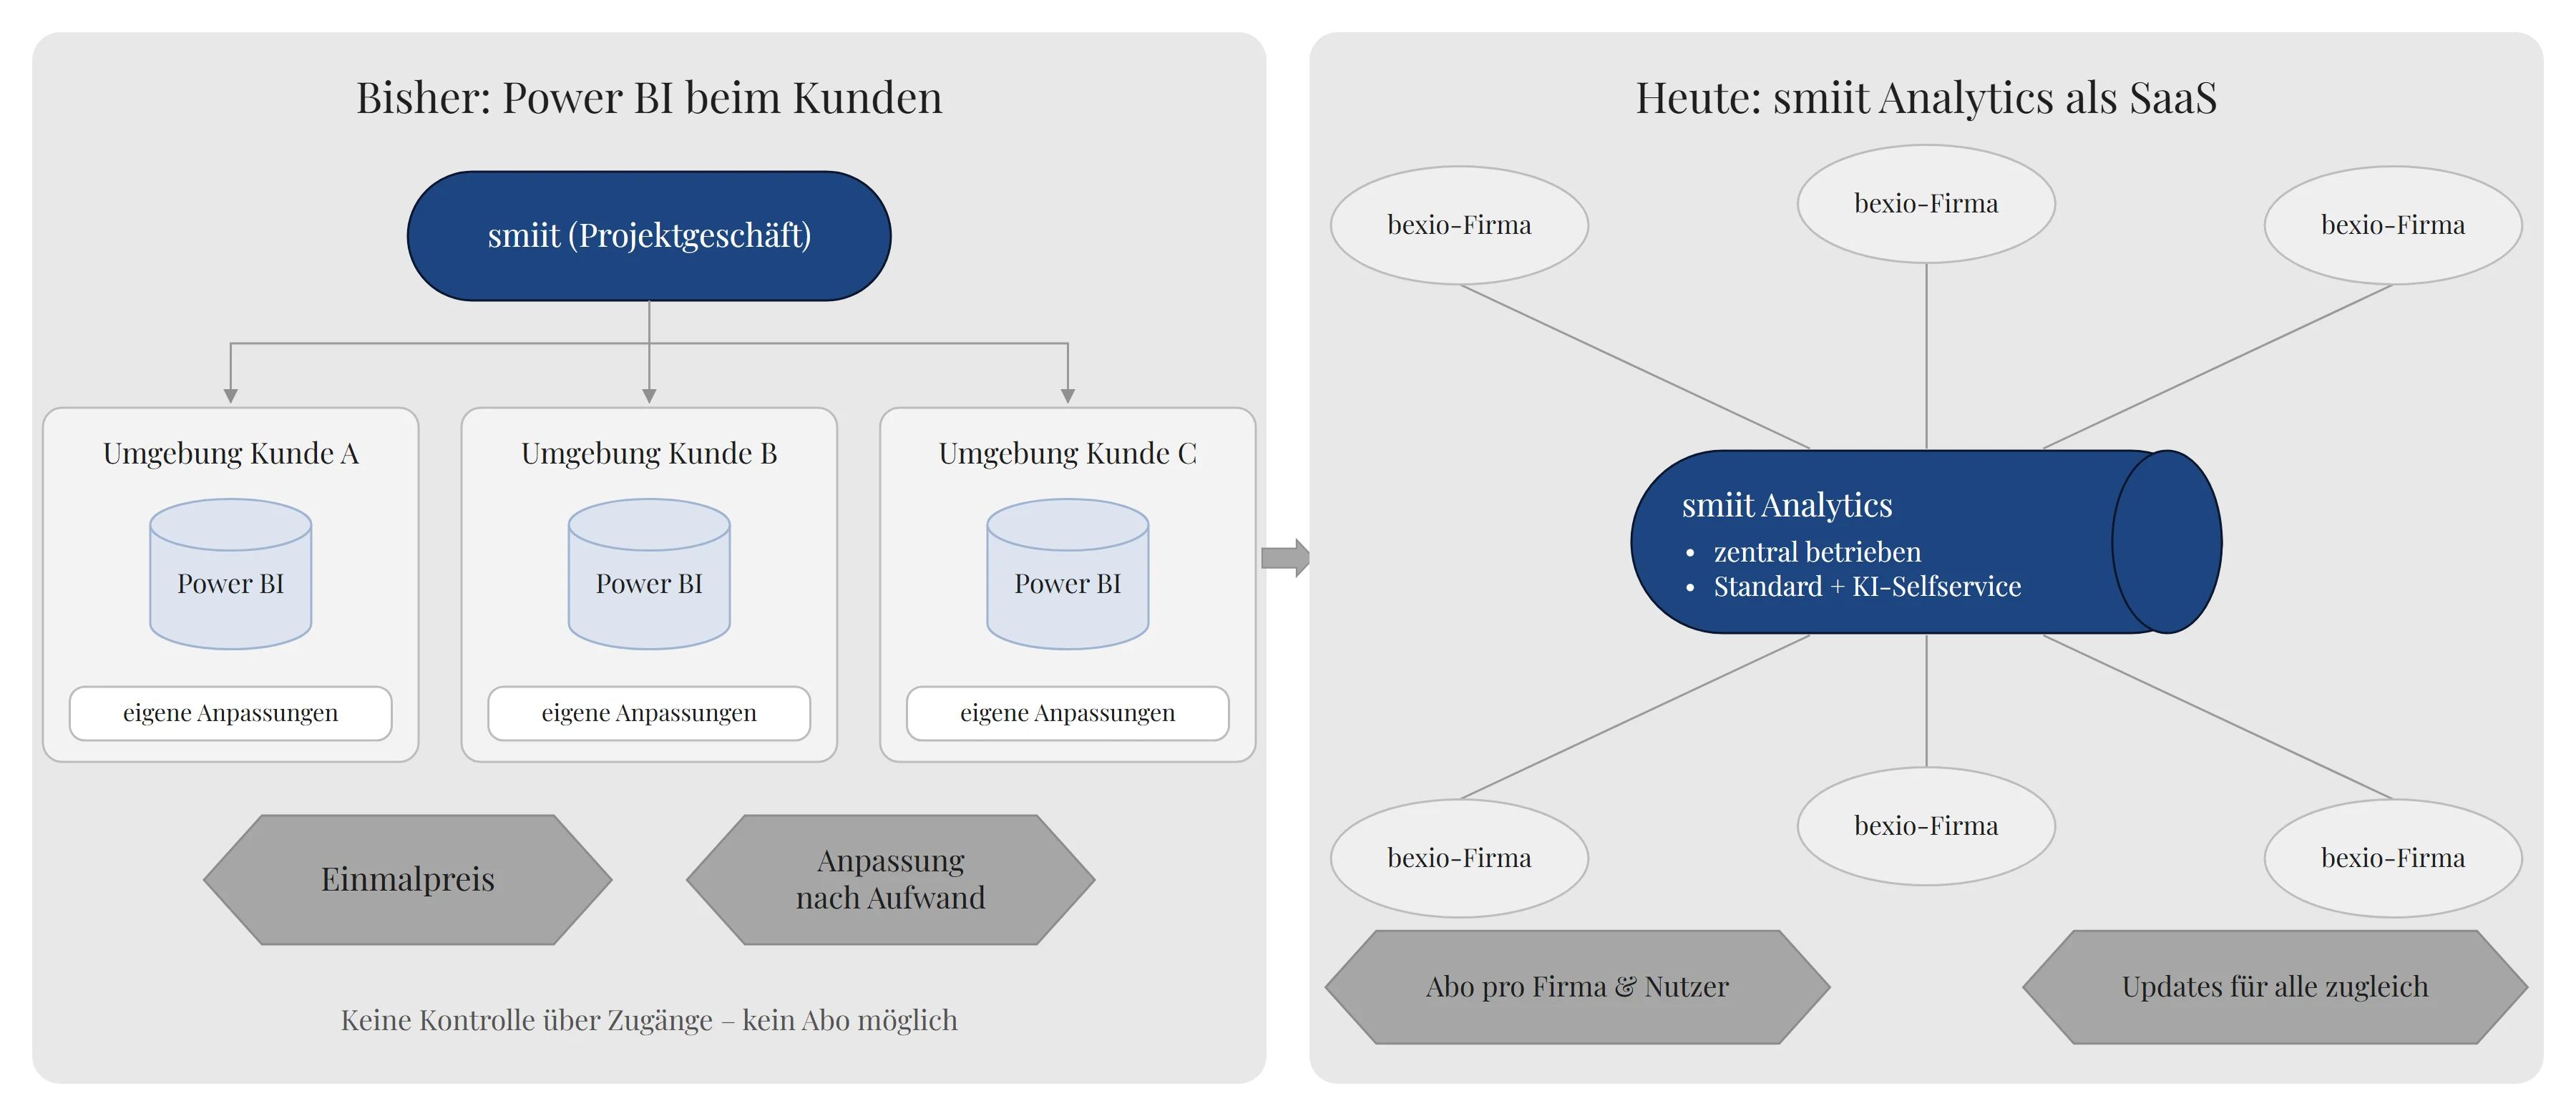
Weil die Lösung einmalig beim Kunden eingerichtet und dort gehostet wurde, hatten wir keine Kontrolle über Zugänge und Nutzung. Ein nutzungs- oder nutzerbasiertes Abo war damit praktisch nicht umsetzbar. Übrig blieb ein Einmalpreis.
Hinzu kam: Fast jeder Kunde wollte Anpassungen. Und jede Anpassung war Entwicklungsarbeit, die wir nach Aufwand abrechnen mussten. Die Wünsche fielen dabei in zwei klar erkennbare Gruppen:
- Operativ geführte Unternehmen wollten vor allem Personalauswertungen. Gefragt waren Stundenrapporte, Auslastung und Soll-/Ist-Zeiten, oft kombiniert mit Automatisierungen wie dem regelmäßigen Mailversand an Mitarbeitende.
- Treuhänder und Buchhaltungsverantwortliche interessierten sich für die Finanzdaten. Sie wollten Bilanz, Erfolgsrechnung und Kennzahlen genau so gegliedert sehen, wie sie es für ihre Mandate brauchen.
Für viele Kunden, gerade kleinere, summierten sich Einmalpreis und Anpassungsaufwand auf einen Betrag, der zu ihrem Budget nicht passte. Wir hatten ein gutes Produkt mit einem Preismodell, das seine eigene Zielgruppe ausschloss.
Die Lehre dahinter
Rückblickend standen wir mitten in einem Spannungsfeld, das in der Literatur gut beschrieben ist. Cusumano zeigt, wie sich das Softwaregeschäft vom Verkauf von Produktlizenzen hin zu Services und wiederkehrenden Erlösen verschiebt, und welche Folgen das für Margen und Geschäftsmodelle hat. Pine beschreibt unter dem Begriff Mass Customization die Herausforderung, individuelle Leistungen zu den Kosten eines Standardprodukts anzubieten.[2][3]
Unser Power-BI-Produkt war an beiden Stellen falsch positioniert. Es war ein Produkt mit Projektlogik: standardisiert im Kern, aber jede Individualisierung kostete genauso viel wie im Projektgeschäft. Die Konsequenz war klar. Wir brauchten ein Produkt, bei dem Individualisierung nicht mehr Entwicklungsaufwand auf unserer Seite bedeutet.
Die Neuausrichtung: Was das neue Produkt leisten musste
Bevor wir eine Zeile Code geschrieben haben, haben wir die Anforderungen neu formuliert. Die wichtigsten waren:
- 1Echte SaaS statt InstallationEine zentral betriebene Anwendung, in der viele Kunden sicher voneinander getrennt arbeiten. Nur so werden Updates, Support und ein Abo-Modell überhaupt möglich.
- 2Ein faires, planbares PreismodellEin Abonnement pro verbundener bexio-Firma und pro Nutzer, vertrieben über den bexio Marketplace, statt eines hohen Einmalpreises.
- 3Individualisierung ohne EntwicklungsaufwandDie Anpassungswünsche aus der Power-BI-Zeit sollten entweder im Standard enthalten sein oder vom Kunden selbst umgesetzt werden können.
- 4Keine Einrichtung beim KundenAnmeldung, bexio verbinden, fertig. Die Daten sollen ohne manuelle Exporte automatisch aktuell bleiben.
- 5Datenschutz als GrundvoraussetzungEs geht um Buchhaltungs- und Personaldaten. Mandantentrennung, Verschlüsselung und nachvollziehbare Zugriffe sind hier nicht verhandelbar.
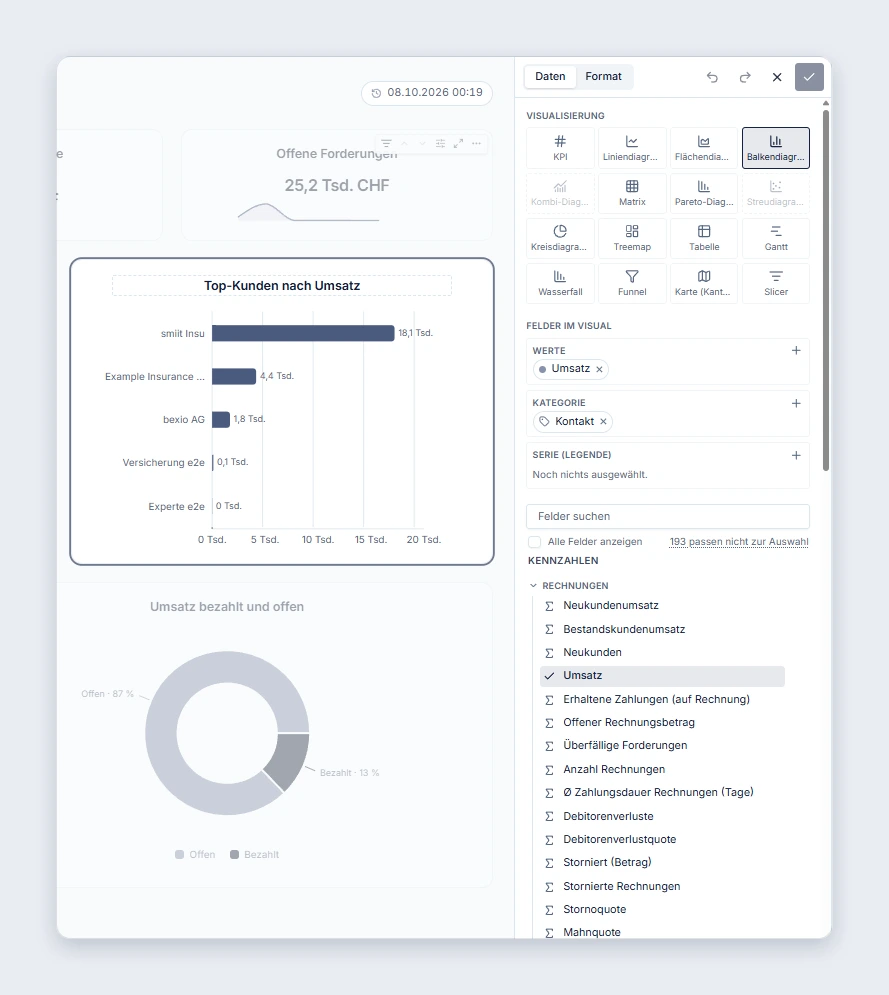
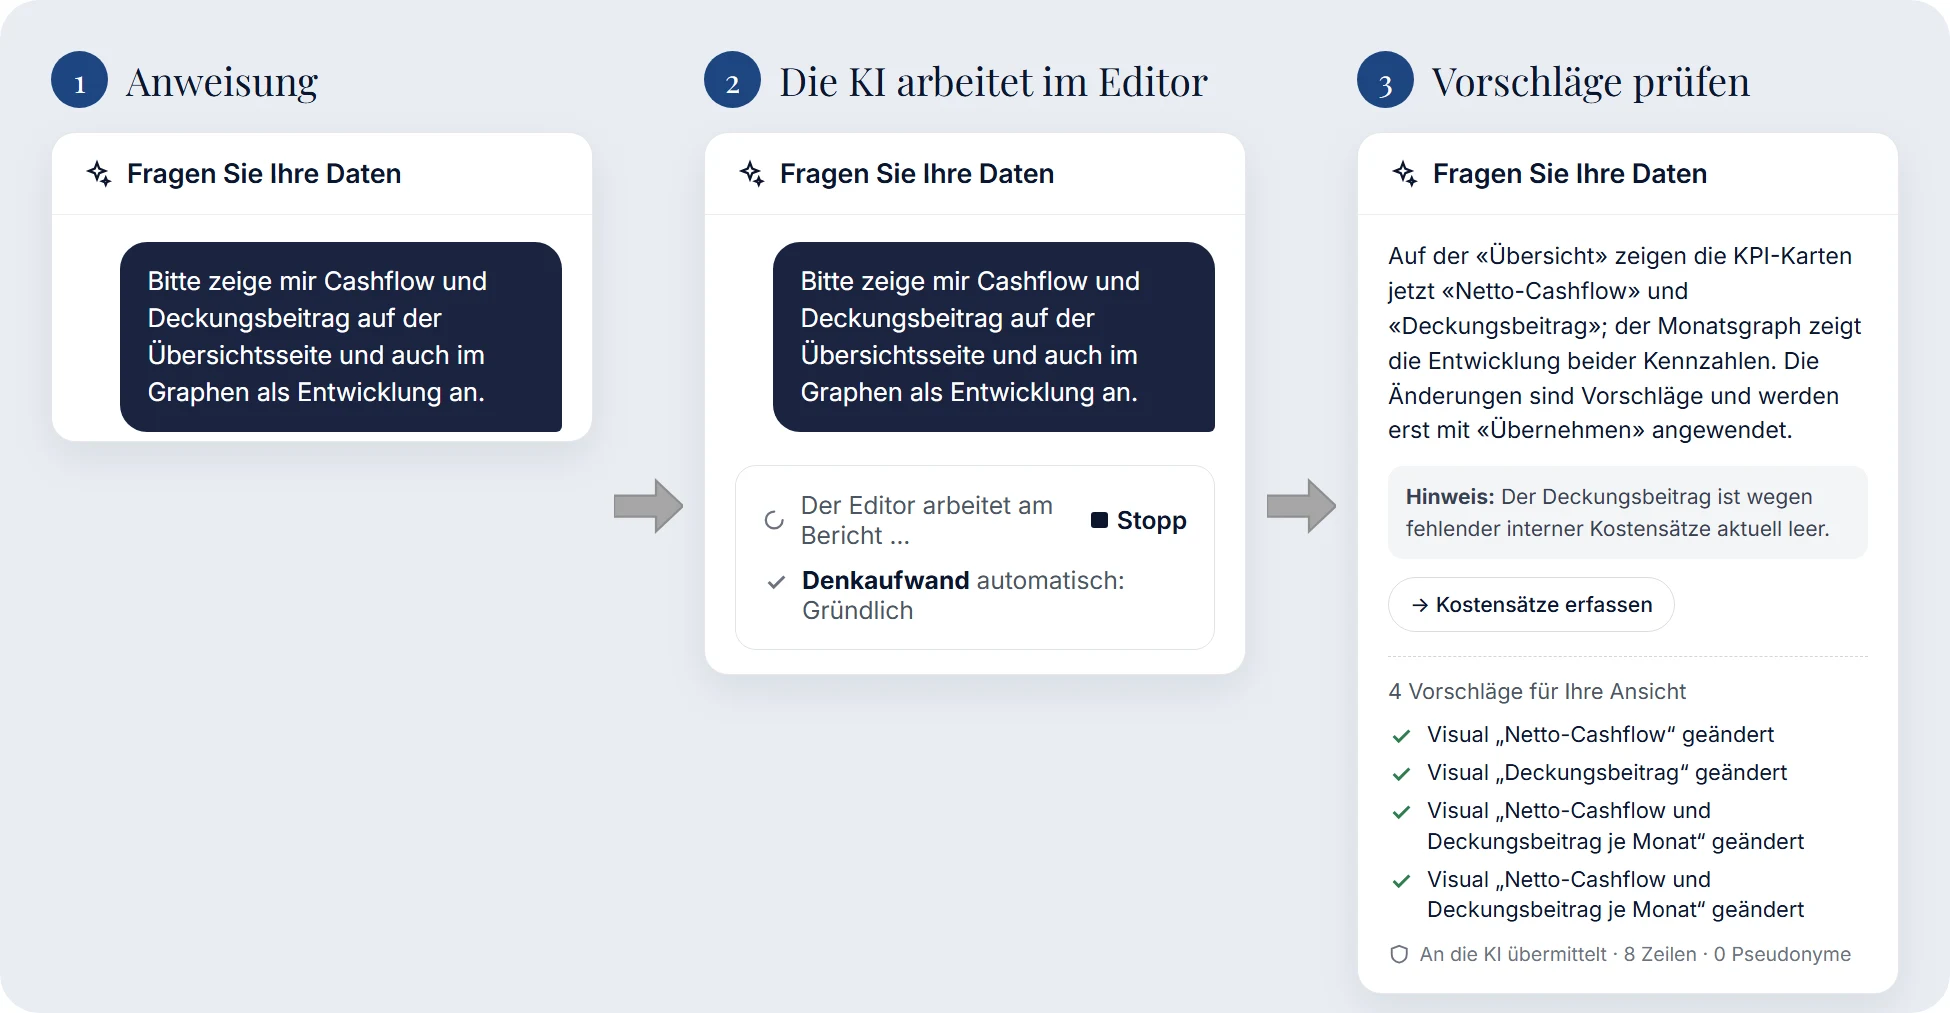
Aus Anforderung 3 folgte die wichtigste Produktentscheidung: Wir kombinieren einen starken Standard mit KI-Unterstützung. Die typischen Wünsche aus der Power-BI-Zeit, also Stunden, Auslastung, Bilanz, Erfolgsrechnung und Kennzahlen, haben wir direkt im Standardbericht abgebildet. Für alles, was darüber hinausgeht, können Kunden ihre Berichte selbst erstellen und anpassen, auf Wunsch mit Hilfe einer KI, die Fragen an die Daten beantwortet und Berichte bearbeitet. So lassen sich auch sehr individuelle Anforderungen in einem Standardprodukt abbilden.
Warum nicht einfach Power BI Embedded?
Die Frage lag nahe, und wir haben sie ernsthaft geprüft. Power BI Embedded ist für klassische Berichte stark. Für unser Ziel hätte es uns aber an ein Lizenz- und Einbettungsmodell gebunden, das wir nicht kontrollieren, und damit genau die Kostenstruktur zurückgebracht, der wir entkommen wollten. Auch das Einbetten eines Open-Source-BI-Tools wie Metabase oder Superset haben wir verworfen: Es fühlt sich für Anwender schnell wie ein Fremdkörper an und lässt kaum Raum für eine KI, die tief in Datenmodell und Berichte integriert ist.
Wir haben uns deshalb für eine eigene Anwendung entschieden, gebaut auf bewährten Open-Source-Bausteinen.
Die Architektur im Überblick
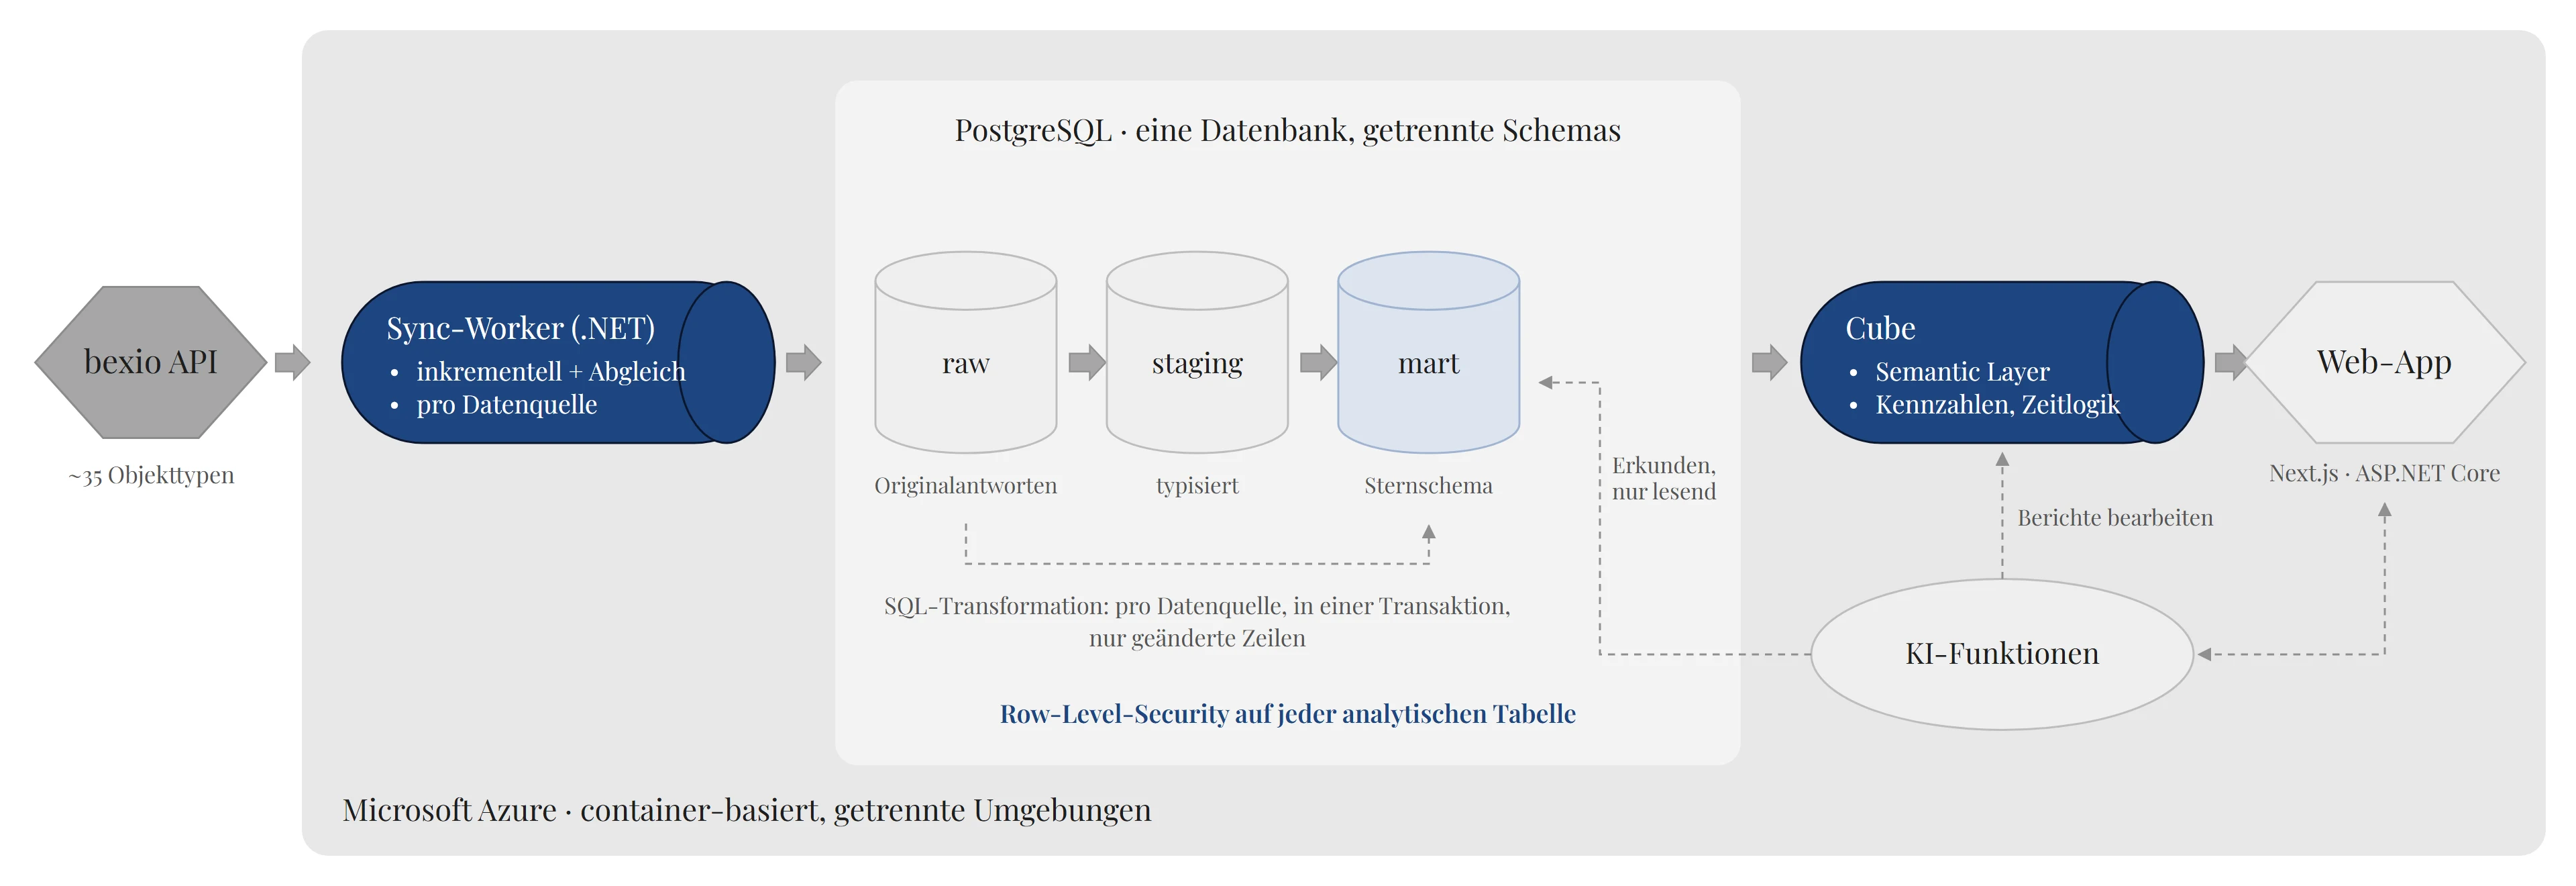
Der Datenfluss lässt sich in fünf Stufen beschreiben:
| Schicht | Technologie | Aufgabe |
|---|---|---|
| Datenanbindung | .NET Worker Service | Lädt rund 35 Objekttypen aus bexio: Buchhaltung, Aufträge, Rechnungen, Bank, Projekte, Zeiten, Personal |
| Rohdaten & Staging | PostgreSQL (raw, staging) | Speichert die Originalantworten unverändert und überführt sie in typisierte Tabellen |
| Analytisches Modell | PostgreSQL (mart) | Sternschema mit Fakten und Dimensionen, aufbereitet für Auswertungen |
| Semantic Layer | Cube | Definiert Kennzahlen, Beziehungen und Zeitlogik zentral, eine Abfragesprache für Berichte und KI |
| Anwendung | Next.js/React, ASP.NET Core API | Berichte, Filter, Bearbeitung, Benutzerverwaltung, KI-Funktionen |
| Betrieb | Microsoft Azure | Container-basiert, automatisierte Deployments über getrennte Umgebungen |
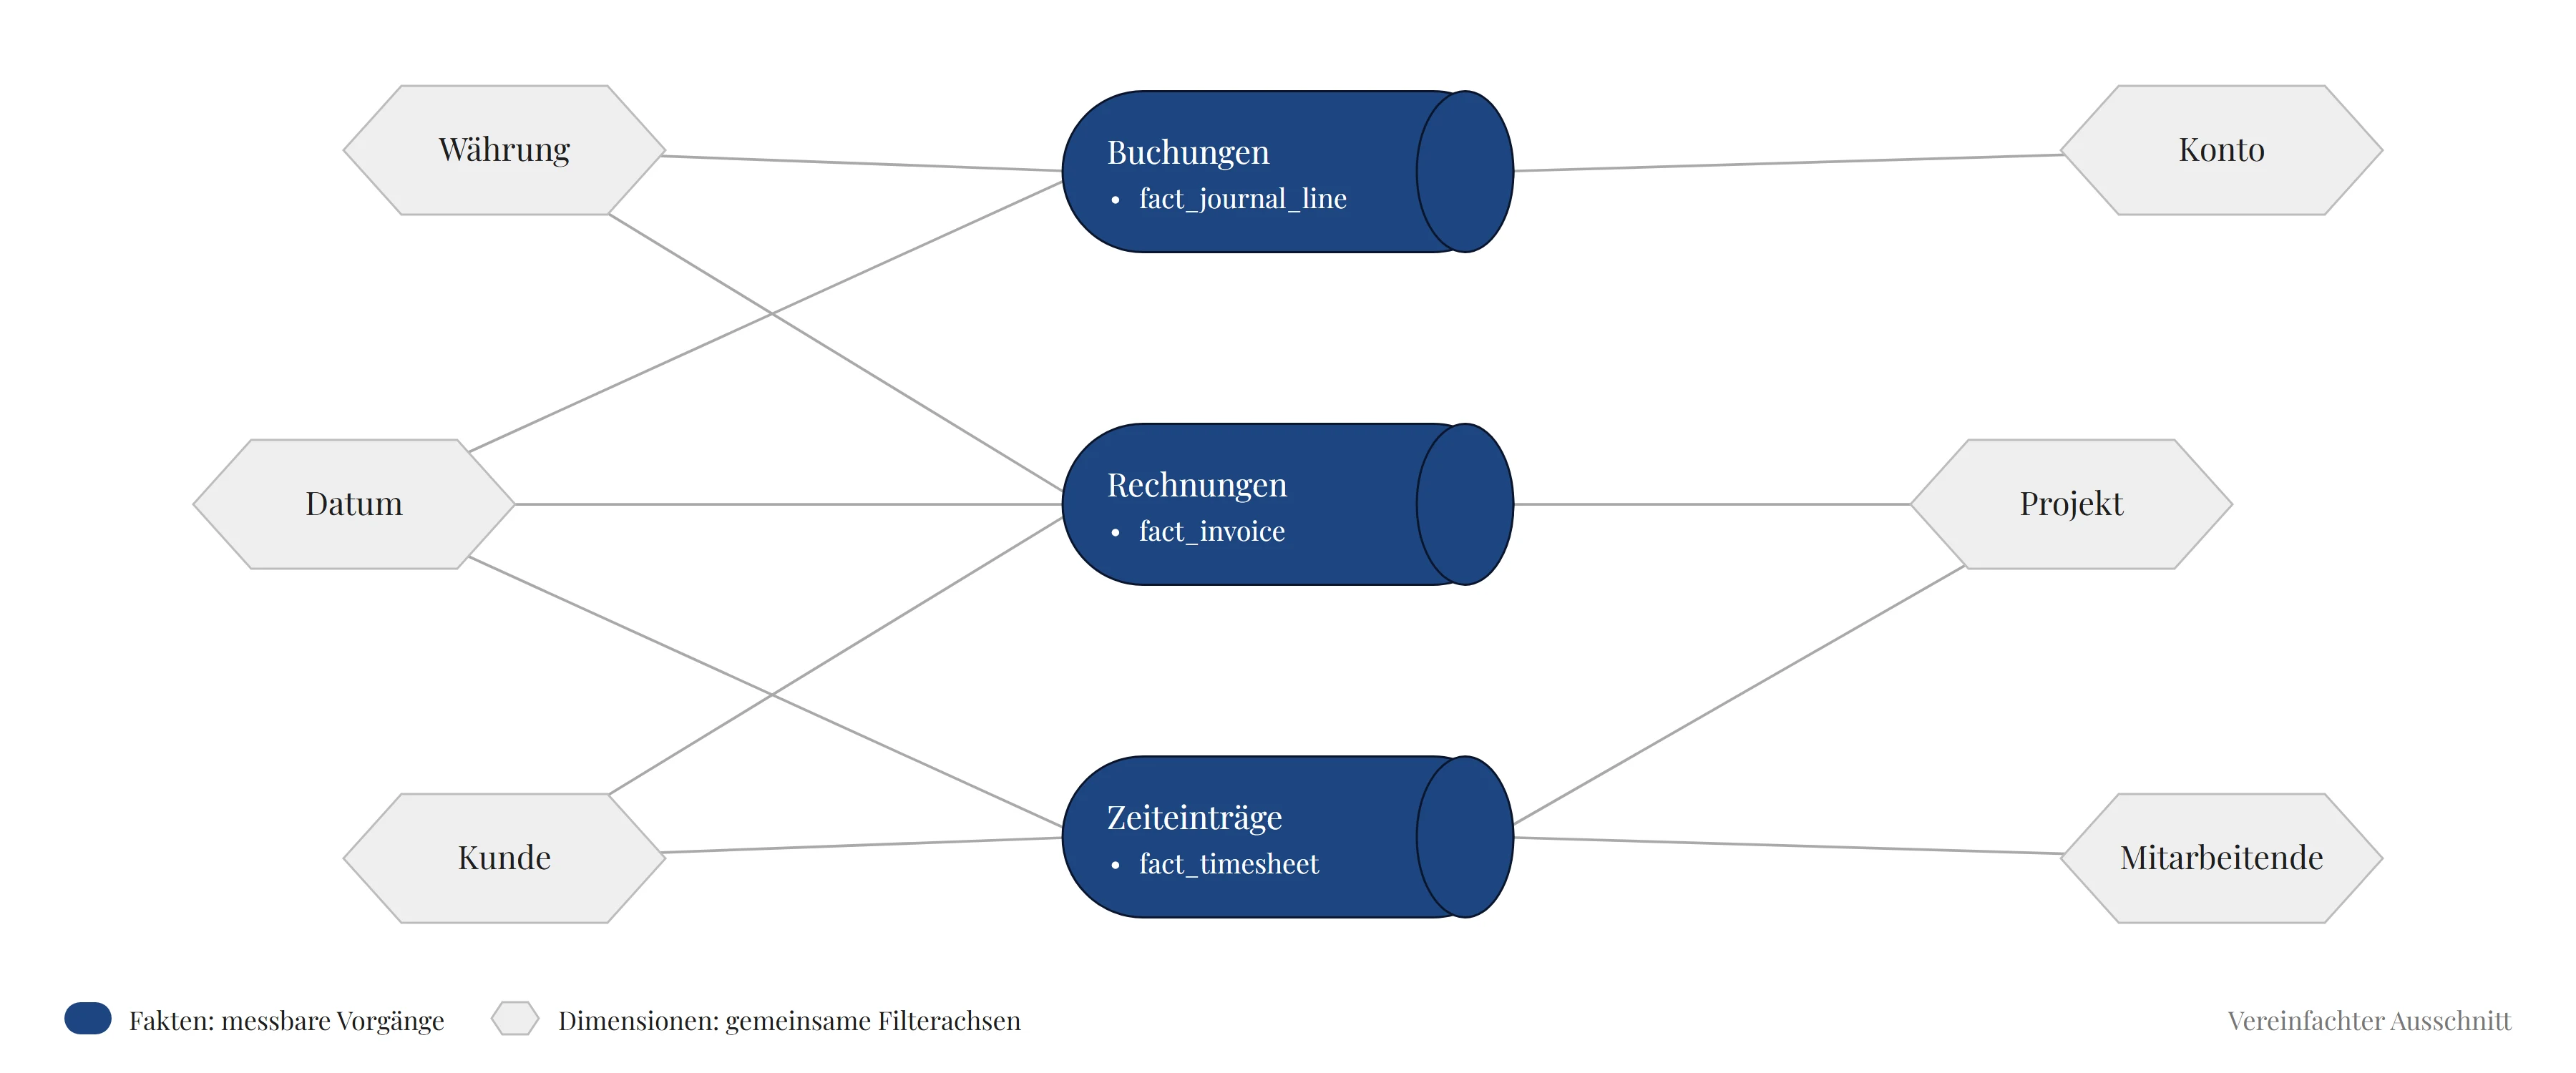
Das analytische Modell folgt der dimensionalen Modellierung nach Kimball und Ross: Fakten wie Buchungen, Rechnungspositionen oder Zeiteinträge werden über gemeinsame Dimensionen wie Datum, Kunde, Konto oder Projekt verbunden. So können Umsatz, offene Posten und Stunden in einem Bericht gemeinsam gefiltert werden, ohne dass jede Kombination einzeln programmiert werden muss.[4]
Berichte sind in smiit Analytics keine fest programmierten Seiten, sondern deklarative Definitionen: Welche Visualisierung zeigt welche Kennzahl nach welcher Dimension. Das hat einen weitreichenden Vorteil. Was als Daten beschrieben ist, kann validiert, versioniert und verglichen werden, und es kann von einer KI bearbeitet werden, ohne dass Code entsteht.
Die größten Herausforderungen und wie wir sie gelöst haben
1. Mandantentrennung, die auch bei Fehlern hält
In einer SaaS-Anwendung teilen sich viele Kunden dieselbe Infrastruktur. Das ist wirtschaftlich der Kern des Modells, und gleichzeitig das größte Risiko. Bezemer und Zaidman weisen darauf hin, dass eine falsche Architekturentscheidung bei der Mandantenfähigkeit schnell zum Wartungsproblem wird. Die Architektur von Force.com zeigt, wie weit ein konsequent geteiltes Modell tragen kann, wenn die Trennung im Fundament verankert ist. Microsoft beschreibt in seinem Architekturleitfaden die Bandbreite von vollständig isolierten bis vollständig geteilten Modellen und die jeweiligen Kompromisse.[5][6][7]
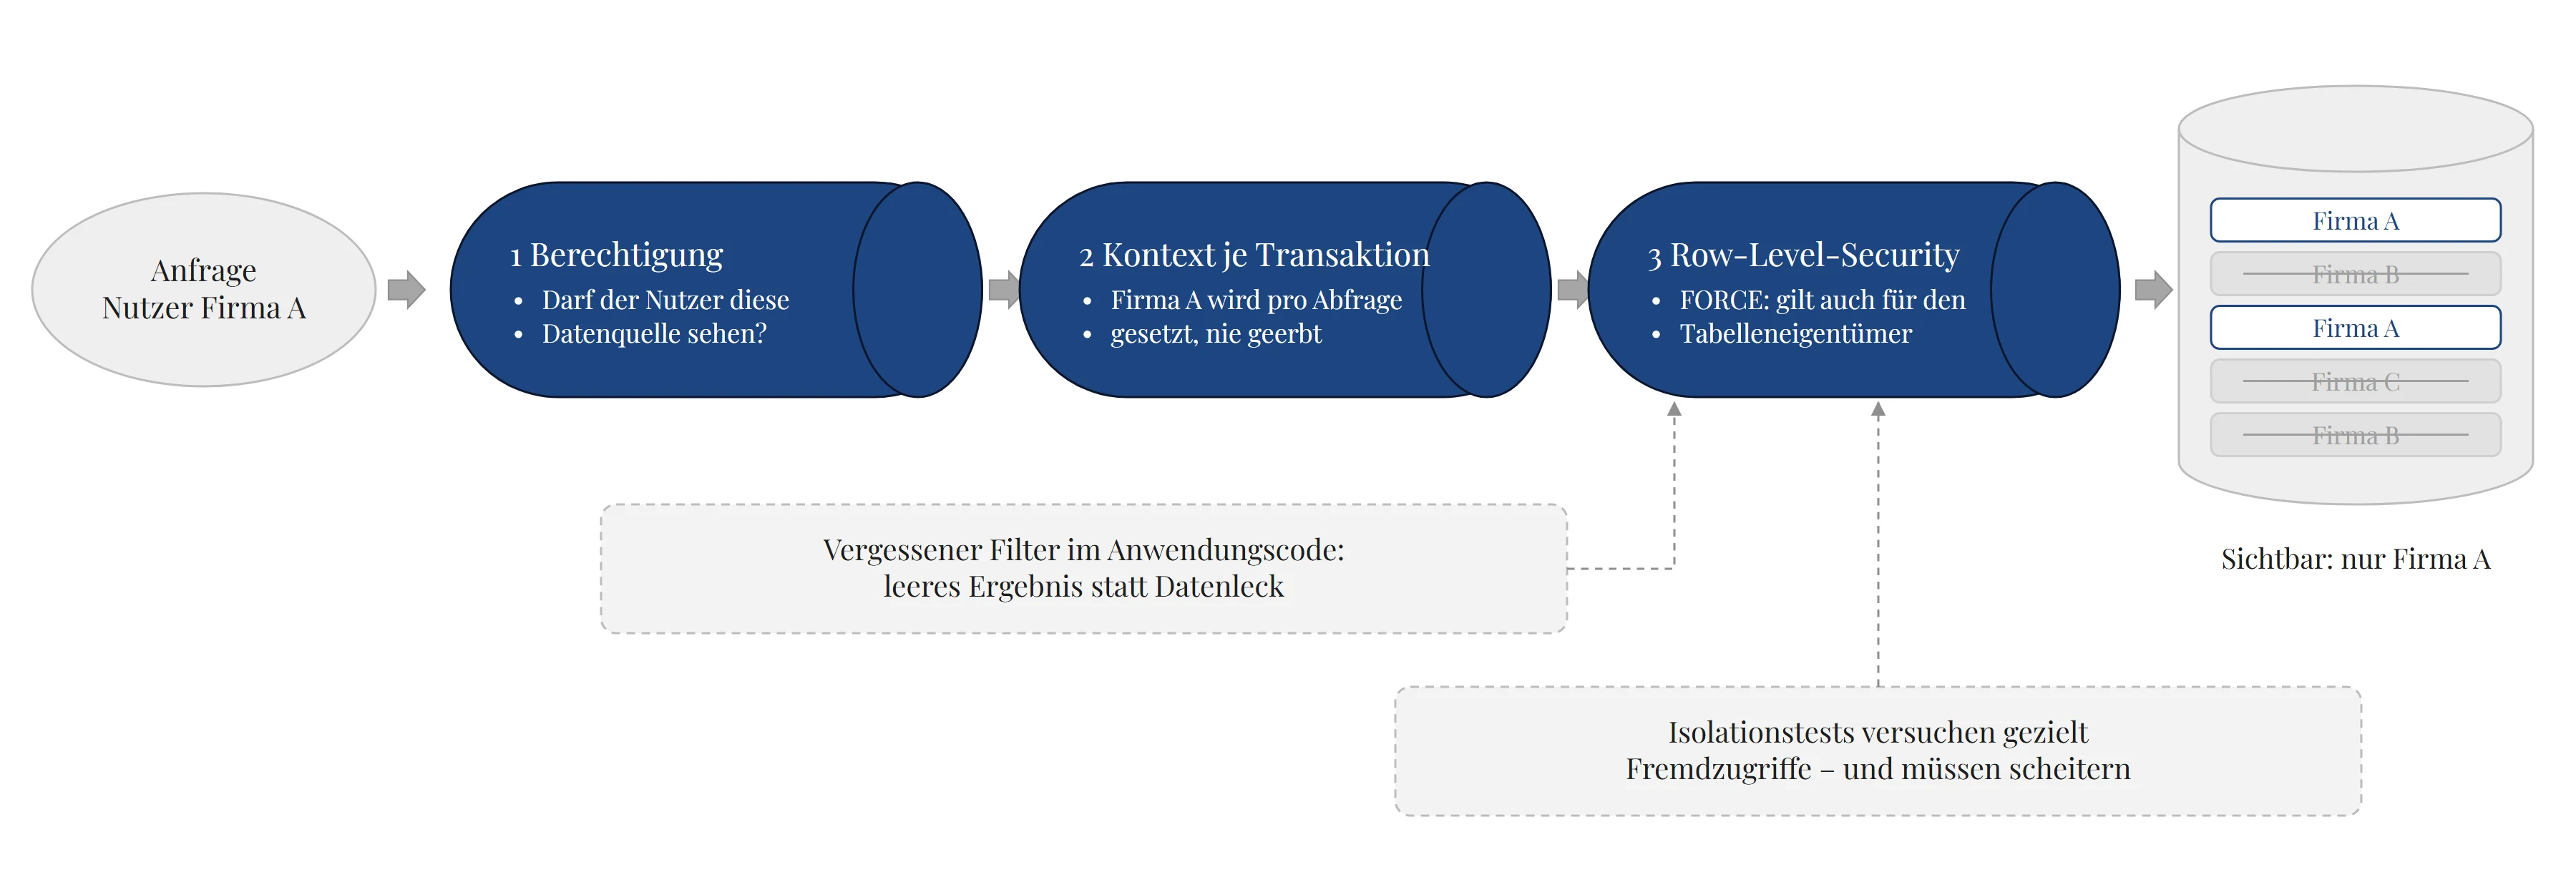
Wir haben uns für ein geteiltes Modell mit mehreren Verteidigungslinien entschieden:
- Die Datenbank ist die letzte Instanz. Jede analytische Tabelle ist durch PostgreSQL Row-Level-Security geschützt. Diese Regeln gelten auch für den Eigentümer der Tabelle (
FORCE ROW LEVEL SECURITY). Ein vergessener Filter im Anwendungscode führt damit nicht zu einem Datenleck, sondern zu einem leeren Ergebnis.[8] - Der Kontext reist mit jeder Abfrage. Welche bexio-Firma abgefragt wird, setzt die Anwendung pro Transaktion. Damit kann bei geteilten Datenbankverbindungen kein Kontext von einer Anfrage in die nächste „durchsickern“.
- Die Grenze liegt bei der Datenquelle. Isoliert wird nicht der einzelne Bericht, sondern die verbundene bexio-Firma. Diese Entscheidung haben wir früh korrigiert. Sie macht es möglich, dass mehrere Berichte und Nutzer auf dieselbe Datenquelle zugreifen, ohne die Trennung aufzuweichen.
- Tests beweisen die Trennung. Automatisierte Tests versuchen gezielt, auf Daten anderer Mandanten zuzugreifen, und müssen daran scheitern.
Dasselbe Prinzip gilt für den Plattformbetrieb. Auch Administratoren von smiit sehen keine Kundendaten, solange der Kunde keinen zeitlich befristeten und protokollierten Supportzugang freigibt.
2. Die bexio-Anbindung: robust statt schnell
Eine Schnittstelle „anzubinden“ ist schnell erledigt. Sie so anzubinden, dass die Daten vieler Kunden mehrmals täglich zuverlässig synchronisiert werden, ist eine andere Aufgabe. Einige Punkte, die uns beschäftigt haben:
- Inkrementell, wo möglich. Wo die API es erlaubt, laden wir nur geänderte Datensätze, mit einem Überlappungsfenster als Sicherheitsnetz. Wo das nicht geht, laden wir vollständig und verwerfen unveränderte Datensätze über einen Hash-Vergleich.
- Gelöschte Daten erkennen. Inkrementelle Abfragen liefern keine Löschungen. In regelmäßigen Abständen gleichen wir deshalb vollständig ab, damit gelöschte Belege nicht dauerhaft in den Auswertungen verbleiben.
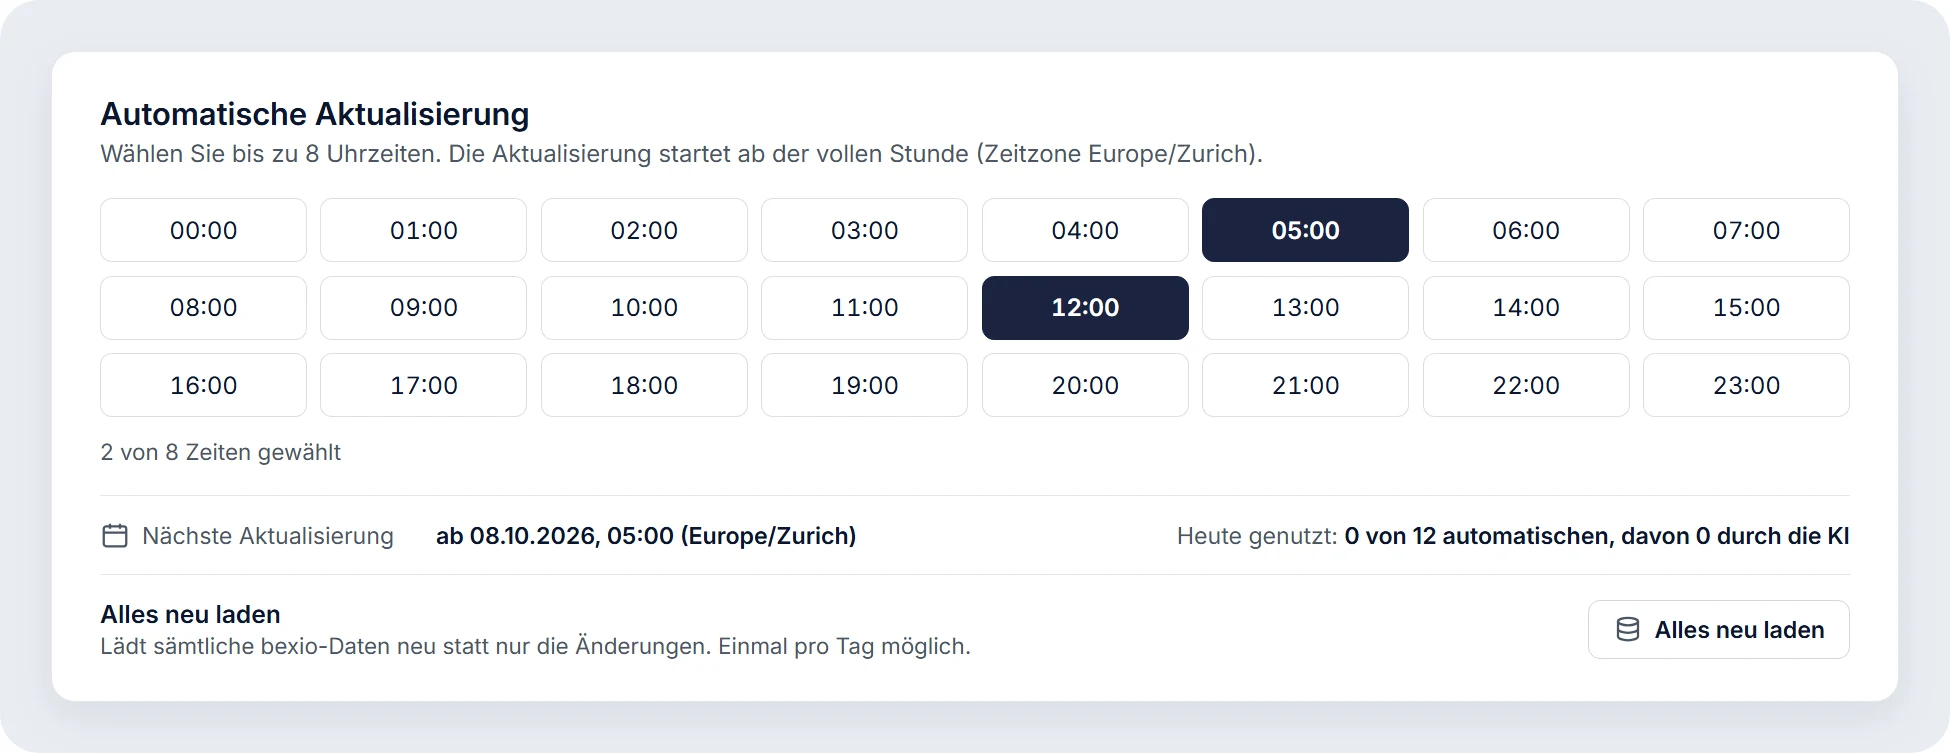
- Faire Lastverteilung. Die API-Limits gelten pro verbundener Firma. Wir begrenzen die Parallelität pro Verbindung und insgesamt, respektieren die Wartezeiten, die die API vorgibt, und verteilen automatische Aktualisierungen mit einem zufälligen Versatz, damit nicht alle Kunden zur vollen Stunde gleichzeitig synchronisieren.
- Zeit ist nicht gleich Zeit. Zeitstempel kommen ohne Zeitzonenangabe in Schweizer Ortszeit. Wer sie als UTC interpretiert, verschiebt Daten um ein bis zwei Stunden, und zweimal im Jahr zusätzlich durch die Sommerzeit.
Aus Kundensicht stecken dahinter ganz einfache Einstellungen: Jede Datenquelle wird zu frei wählbaren Uhrzeiten automatisch aktualisiert, und eine manuelle Aktualisierung ist jederzeit möglich. Ein tägliches Budget an Aktualisierungen hält die Last und damit die Betriebskosten planbar. Auch das ist eine Voraussetzung für einen fairen Abopreis.
3. Eine bewusste Abweichung vom Standard-Stack
Für die Transformation von Rohdaten in das analytische Modell ist dbt heute der De-facto-Standard. Wir haben damit begonnen und uns nach nur einer Woche wieder davon verabschiedet.
Der Grund war eine zentrale Anforderung: Eine Synchronisation muss durchgängig wirken. Wenn ein Kunde auf „Aktualisieren“ klickt, sollen nicht nur die Rohdaten neu geladen werden. Genau die Daten dieses Kunden sollen bis in den Bericht durchgerechnet werden, und zwar sofort. dbt ist als Batch-Werkzeug konzipiert, das ganze Modelle neu baut. Es hätte außerdem eine zweite Laufzeitumgebung und ein zweites Berechtigungskonzept neben die Row-Level-Security gestellt.
- 1Kunde klickt auf „Aktualisieren“
- 2Sync-Worker lädt geänderte Daten aus bexio (raw)
- 3Typisierung in staging
- 4SQL-Schritte bauen das Sternschema (mart)
- 5Alles pro Datenquelle in einer Transaktion
- 6Bericht zeigt sofort die neuen Zahlen
Wir haben die Transformation deshalb als geordnete Abfolge von SQL-Schritten in den .NET-Worker integriert. Sie läuft pro Datenquelle in einer Transaktion, schreibt nur tatsächlich geänderte Zeilen und überspringt sich selbst, wenn sich nichts geändert hat. Das war mehr Eigenentwicklung, als uns lieb war. Aber es ist die Stelle, an der sich die Architektur nach dem Produkt richtet und nicht umgekehrt.
4. Zahlen, die plausibel aussehen und trotzdem falsch sind
Das war die lehrreichste Kategorie von Problemen. Ein Absturz fällt sofort auf. Eine Bilanzsumme, die um den Faktor drei zu hoch ist, fällt womöglich erst dem Treuhänder auf. Einige Beispiele, die wir erst mit echten Daten gefunden haben:
- Eröffnungsbilanzen pro Geschäftsjahr. bexio bucht die Eröffnungssalden in jedem Geschäftsjahr neu. Eine Bilanzabfrage, die nicht auf ein Geschäftsjahr eingeschränkt ist, summiert diese Salden über alle Jahre und bläht das Ergebnis entsprechend auf. Unsere Lösung ist bewusst streng: Solche Abfragen werden vom Semantic Layer abgelehnt, bevor sie die Datenbank erreichen.
- Top-N-Listen mit leeren Einträgen. PostgreSQL sortiert fehlende Werte bei absteigender Sortierung zuerst ein. Eine „Top 10 Kunden nach Umsatz“ zeigte dadurch in bestimmten Kombinationen Kunden ohne Umsatz ganz oben.
- Vorjahresvergleiche mit 0 % Wachstum. Wird ein Vorjahresvergleich nach der Jahres-Dimension statt nach einer echten Zeitachse gruppiert, vergleicht er jedes Jahr mit sich selbst. Das Ergebnis ist mathematisch korrekt und fachlich wertlos.
- Fremdwährungen. Jeder Betrag wird in Originalwährung und in Buchungswährung geführt, umgerechnet mit dem Kurs, der am Belegdatum gültig war, und nicht mit dem heutigen.
Das gemeinsame Muster: Fachliche Regeln der Buchhaltung gehören an eine zentrale Stelle, und wo sie verletzt werden könnten, muss das System lieber ablehnen als raten. Diese Haltung prägt auch den Umgang mit KI.
5. Individuelle Anforderungen im Standardprodukt, mit KI
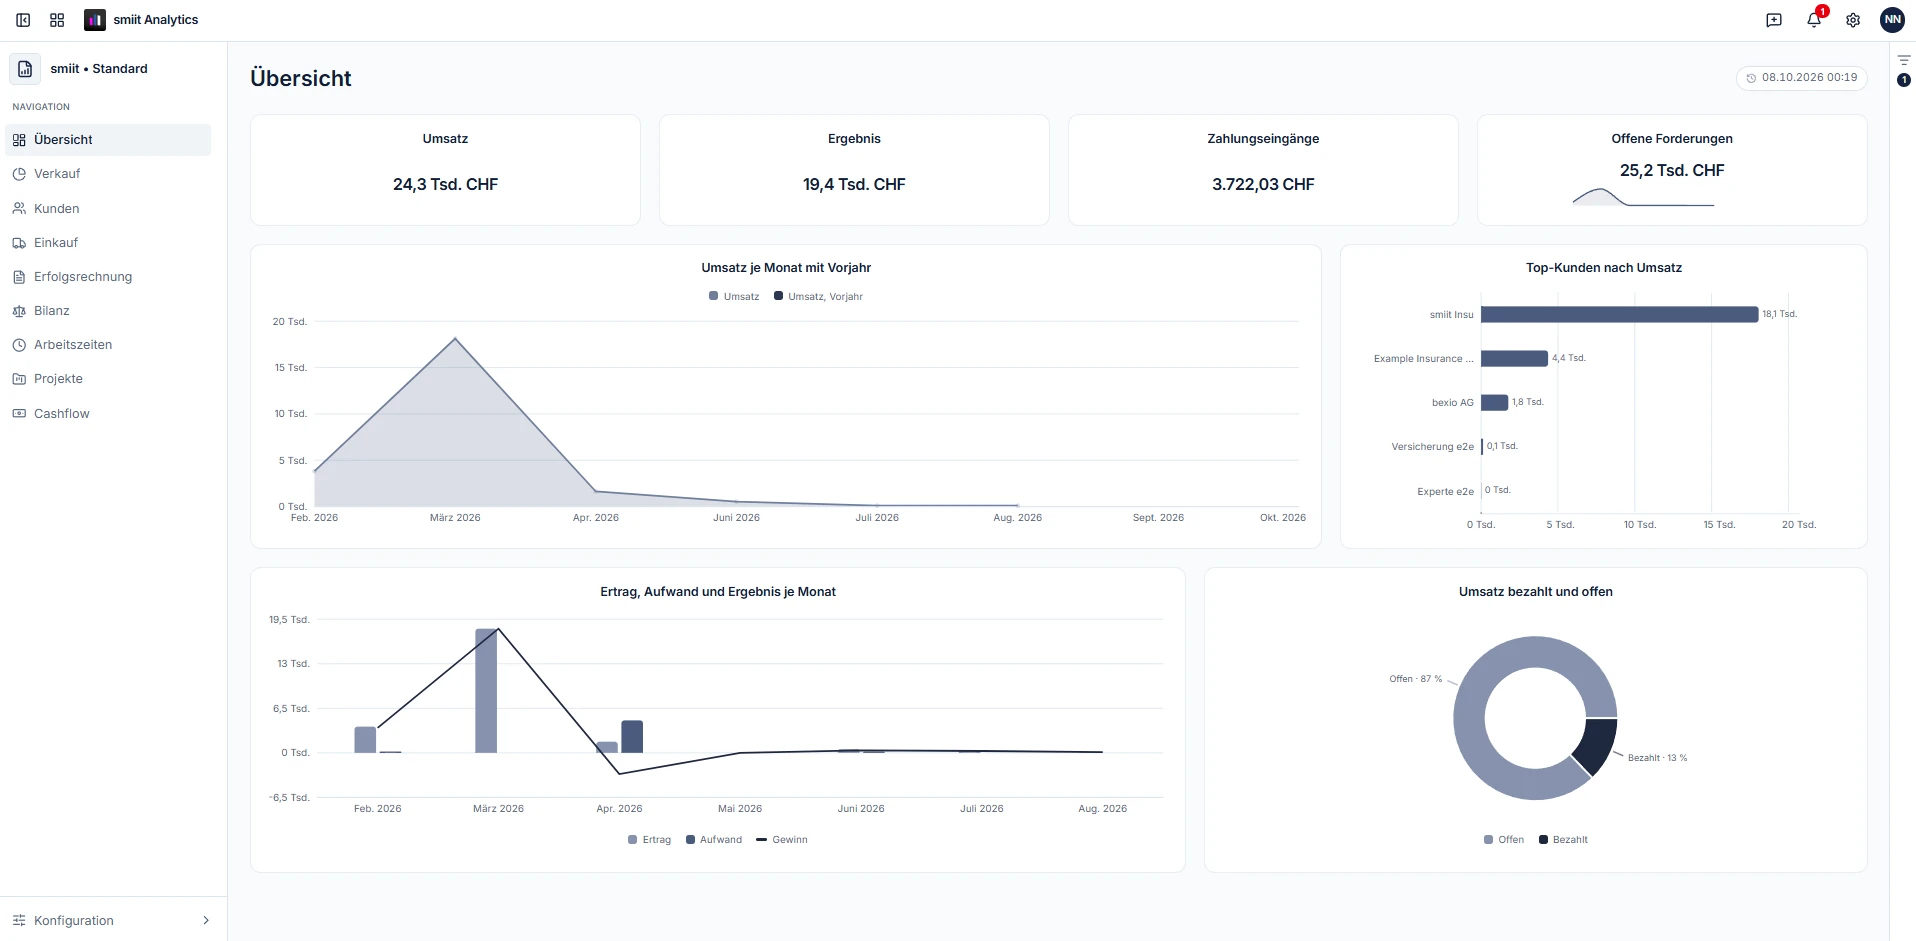
Hier schließt sich der Kreis zur Power-BI-Zeit. Die häufigsten Anpassungswünsche sind heute Teil des Standards. Jeder neue Arbeitsbereich startet mit einem Bericht, der Übersicht, Verkauf, Einkauf, Erfolgsrechnung, Bilanz, Arbeitszeiten, Projekte und Cashflow abdeckt. Dazu kommt ein Katalog betriebswirtschaftlicher Kennzahlen, von Liquiditätsgraden über EBITDA-Marge bis zur Eigenkapitalrendite.
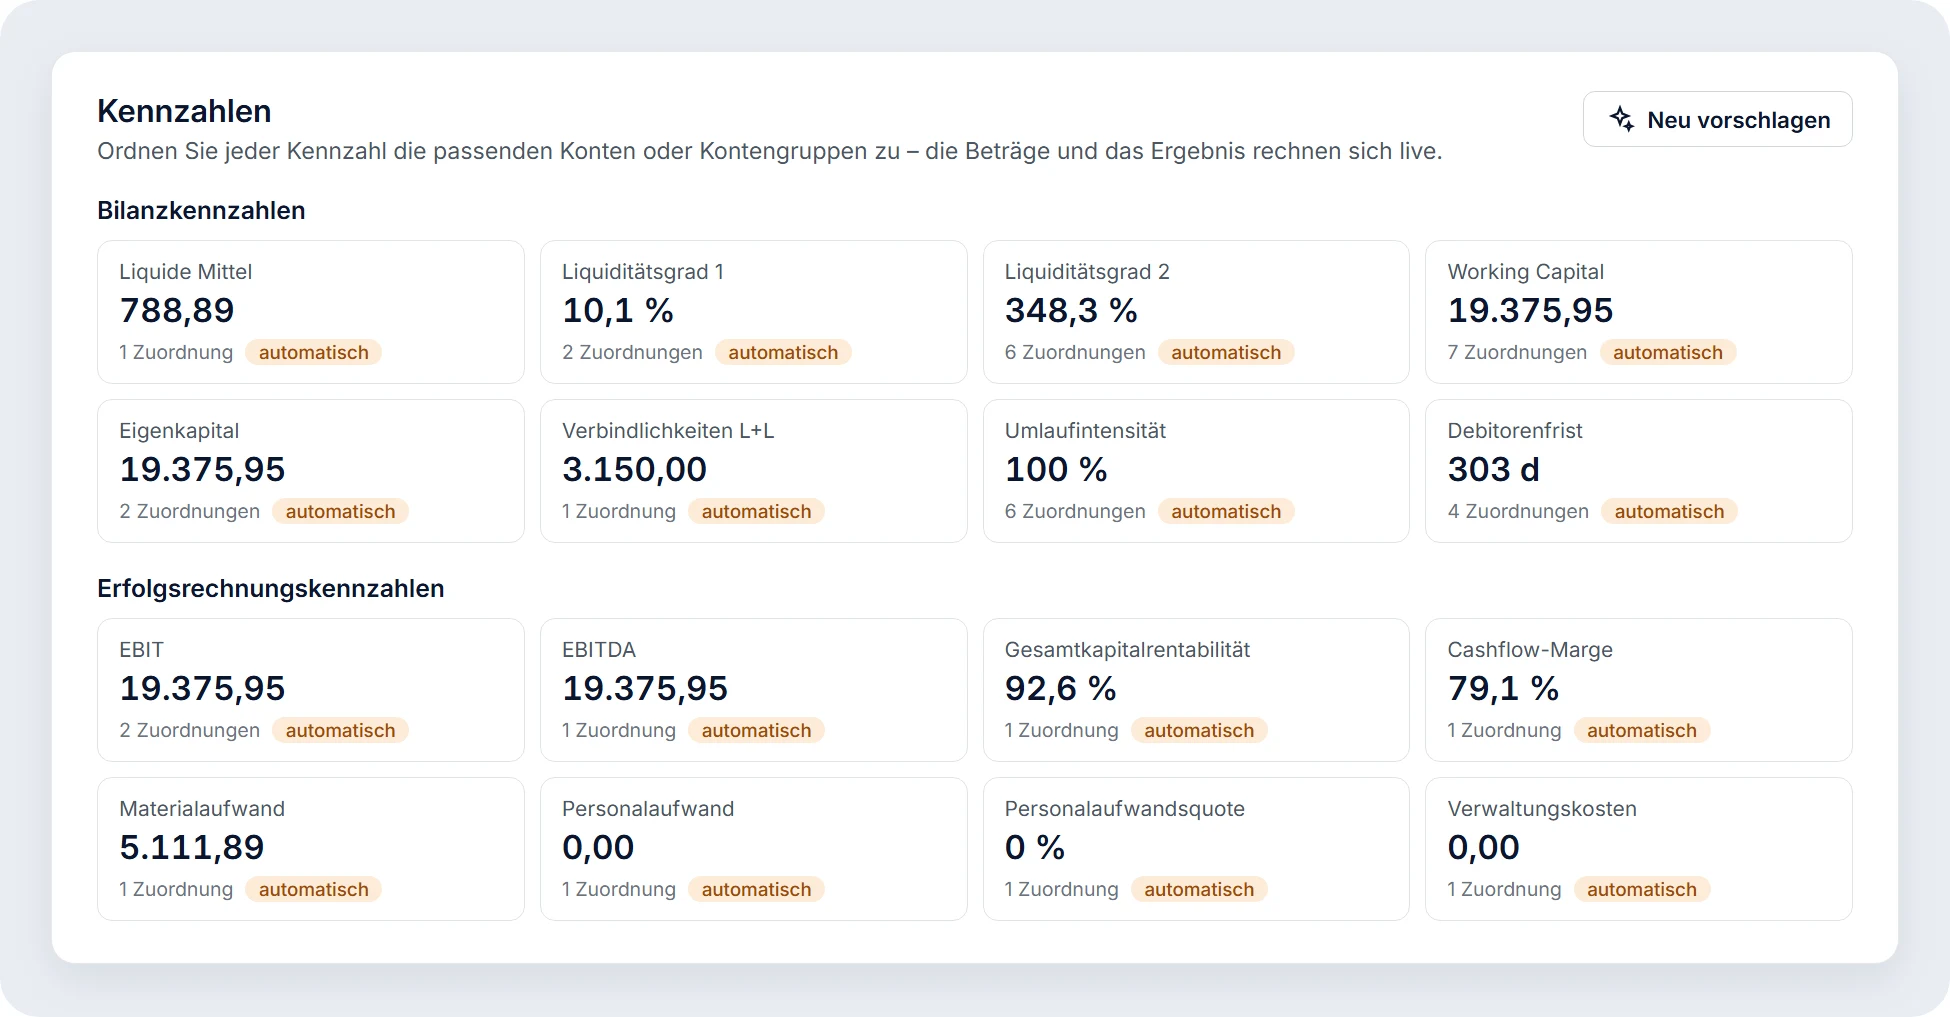
Für die Kennzahlen muss festgelegt werden, welche Konten in welche Größe einfließen. Das ist genau die Arbeit, die früher Anpassungsaufwand verursacht hat. Heute schlägt das System die Zuordnung anhand der Kontenbereiche des Schweizer KMU-Kontenrahmens vor und nutzt bei unklaren Konten eine KI. Der Kunde prüft und bestätigt nur noch.
Darüber hinaus gibt es zwei KI-Funktionen, die wir bewusst unterschiedlich abgesichert haben:
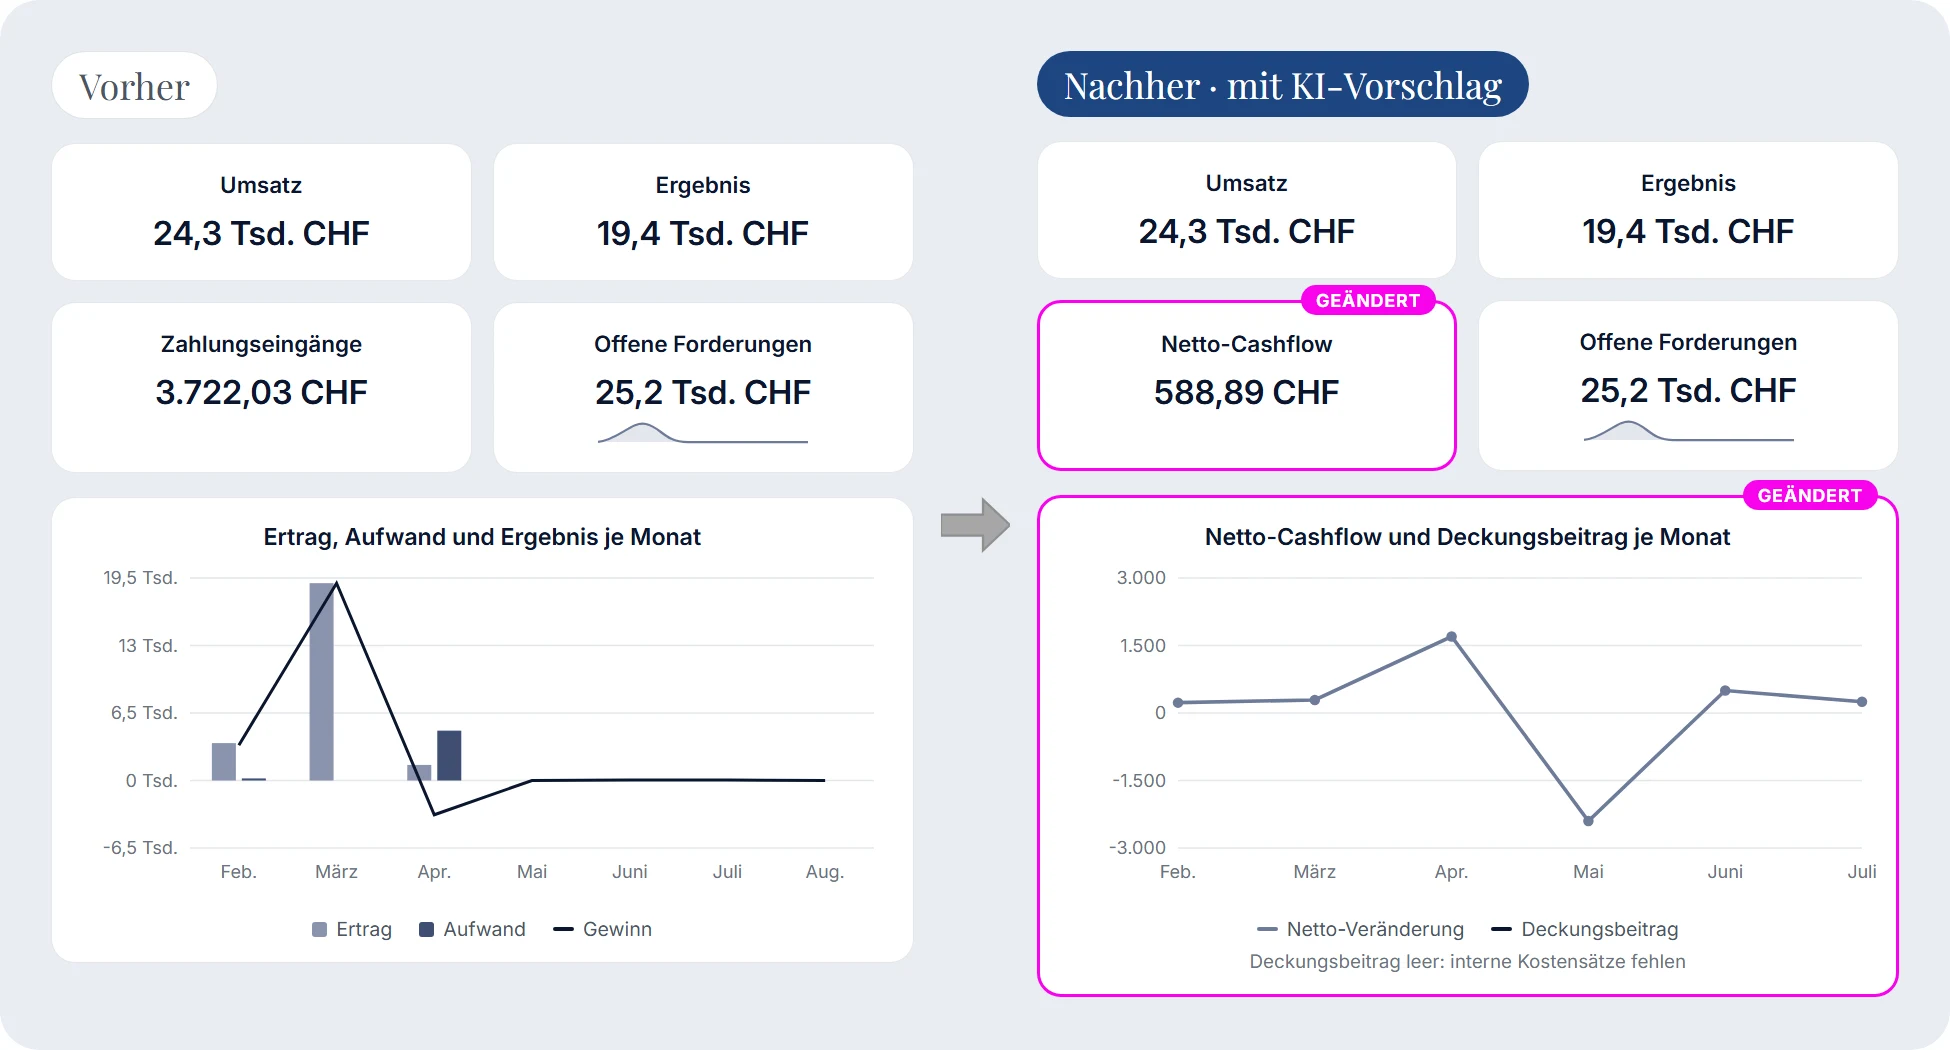
- Berichte erstellen und bearbeiten. Die KI arbeitet ausschließlich über das definierte semantische Modell und verändert Berichtsdefinitionen, keinen Code. Änderungen landen zunächst in einem Entwurf. Gespeichert wird erst, wenn der Anwender zustimmt.
- Daten frei erkunden. Für Fragen, die kein Bericht vorhersieht („Welche Kunden haben ein Zahlungsziel über 60 Tage und eine offene Mahnung, nach Kanton?“), darf die KI lesende Abfragen erzeugen. Diese laufen über eine eigene, rein lesende Datenbankrolle, eine Positivliste erlaubter Tabellen und in einer schreibgeschützten Transaktion, zusätzlich zur Row-Level-Security.
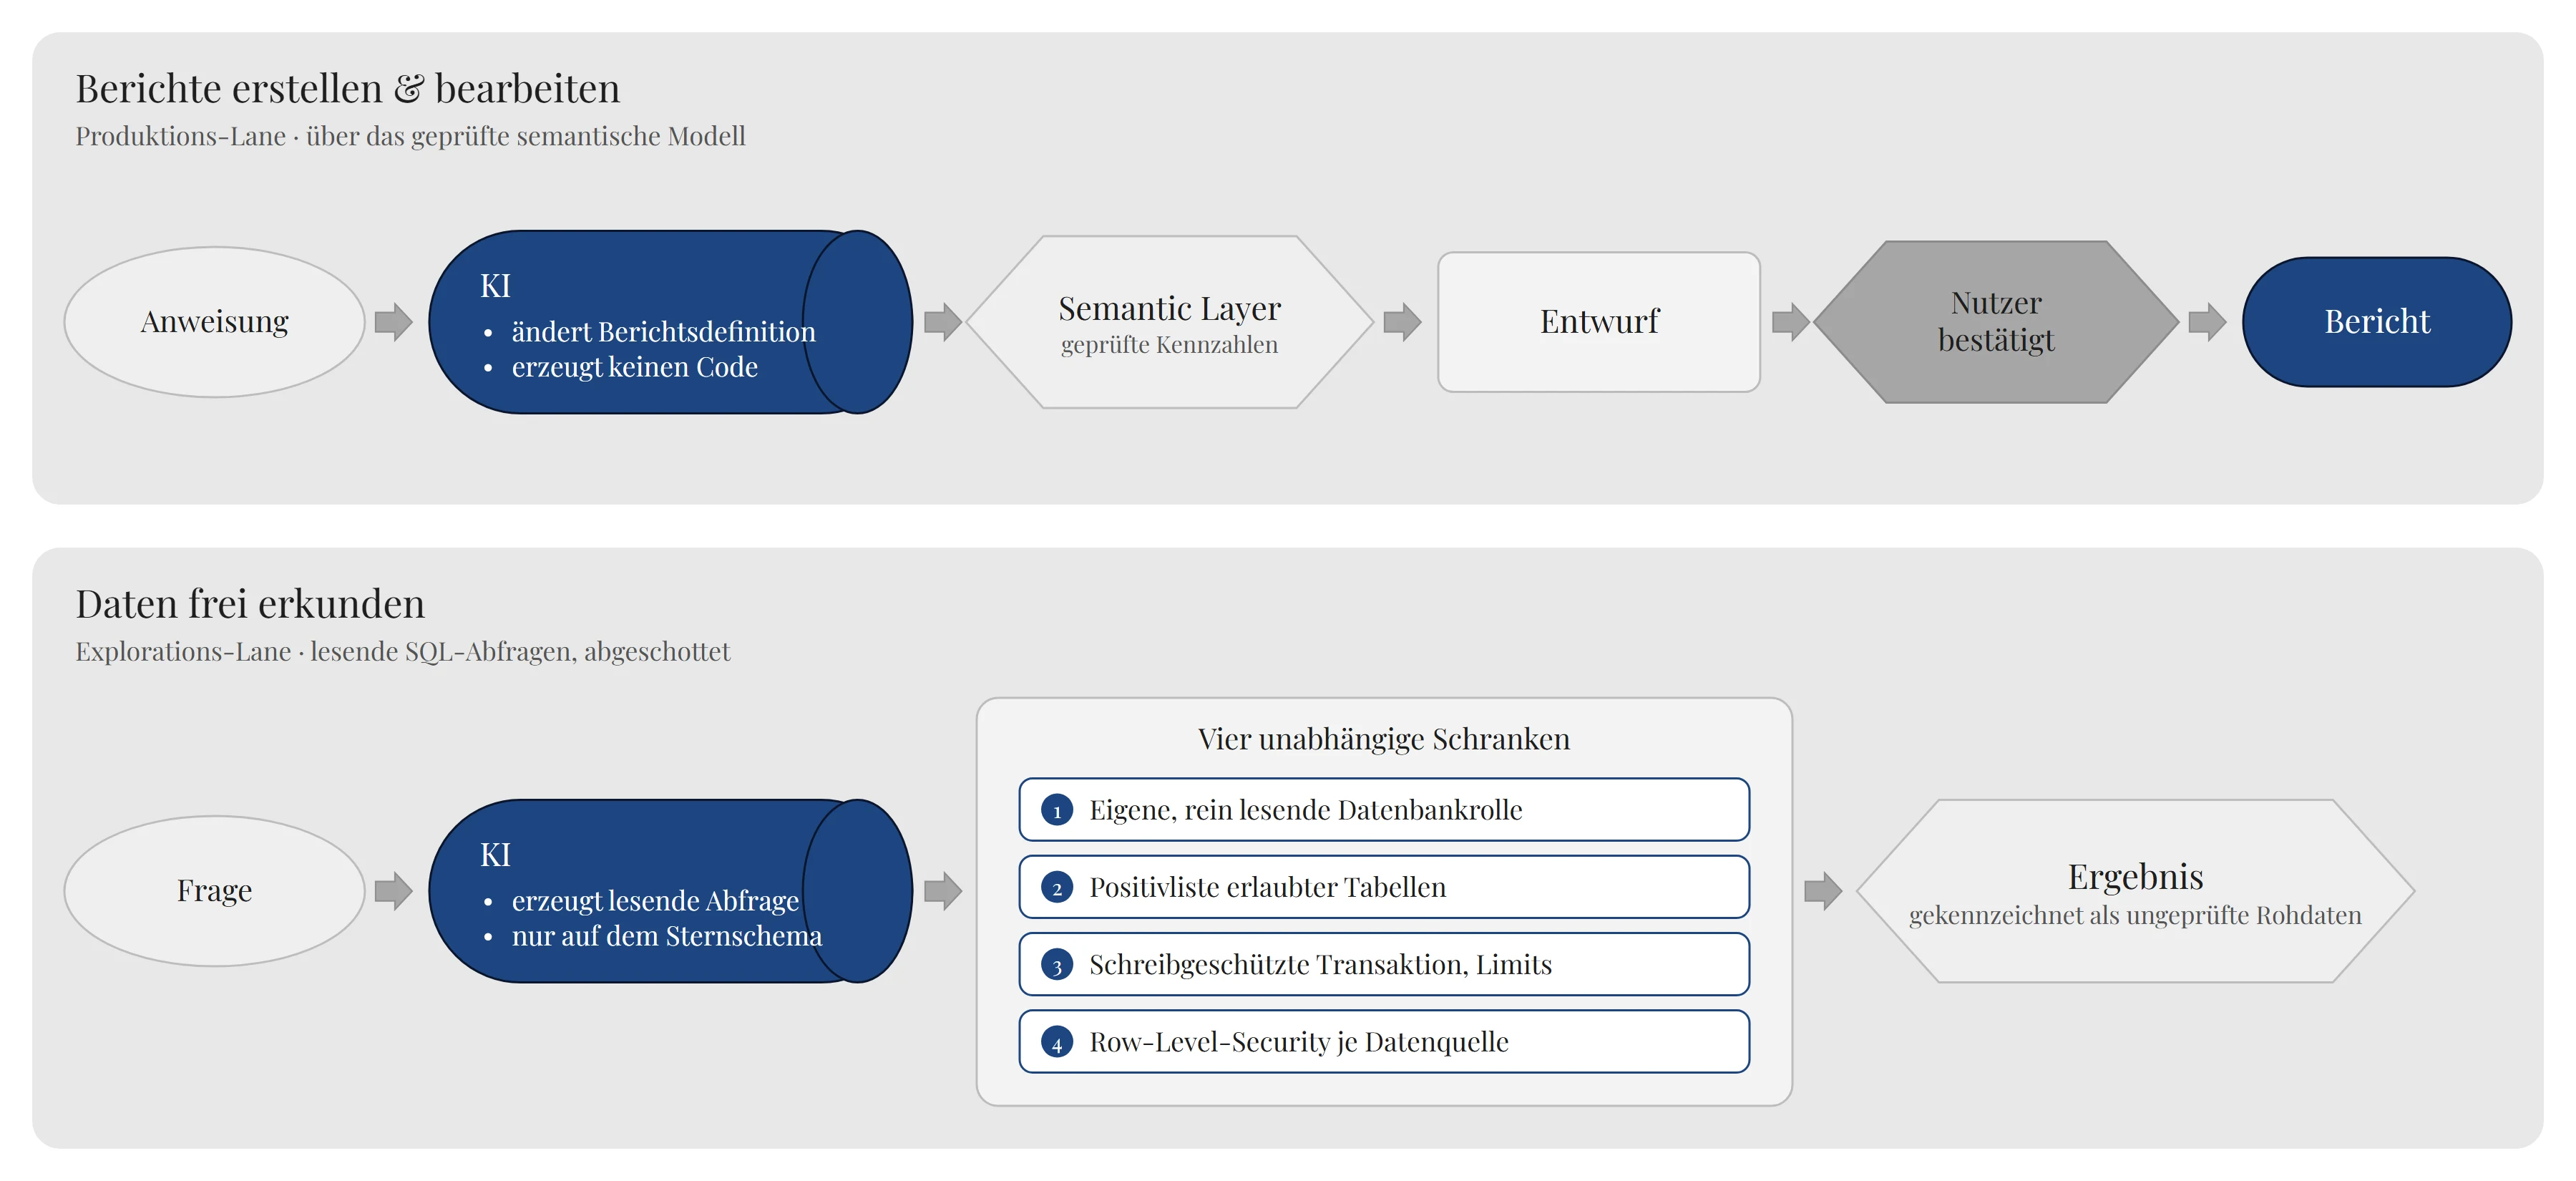
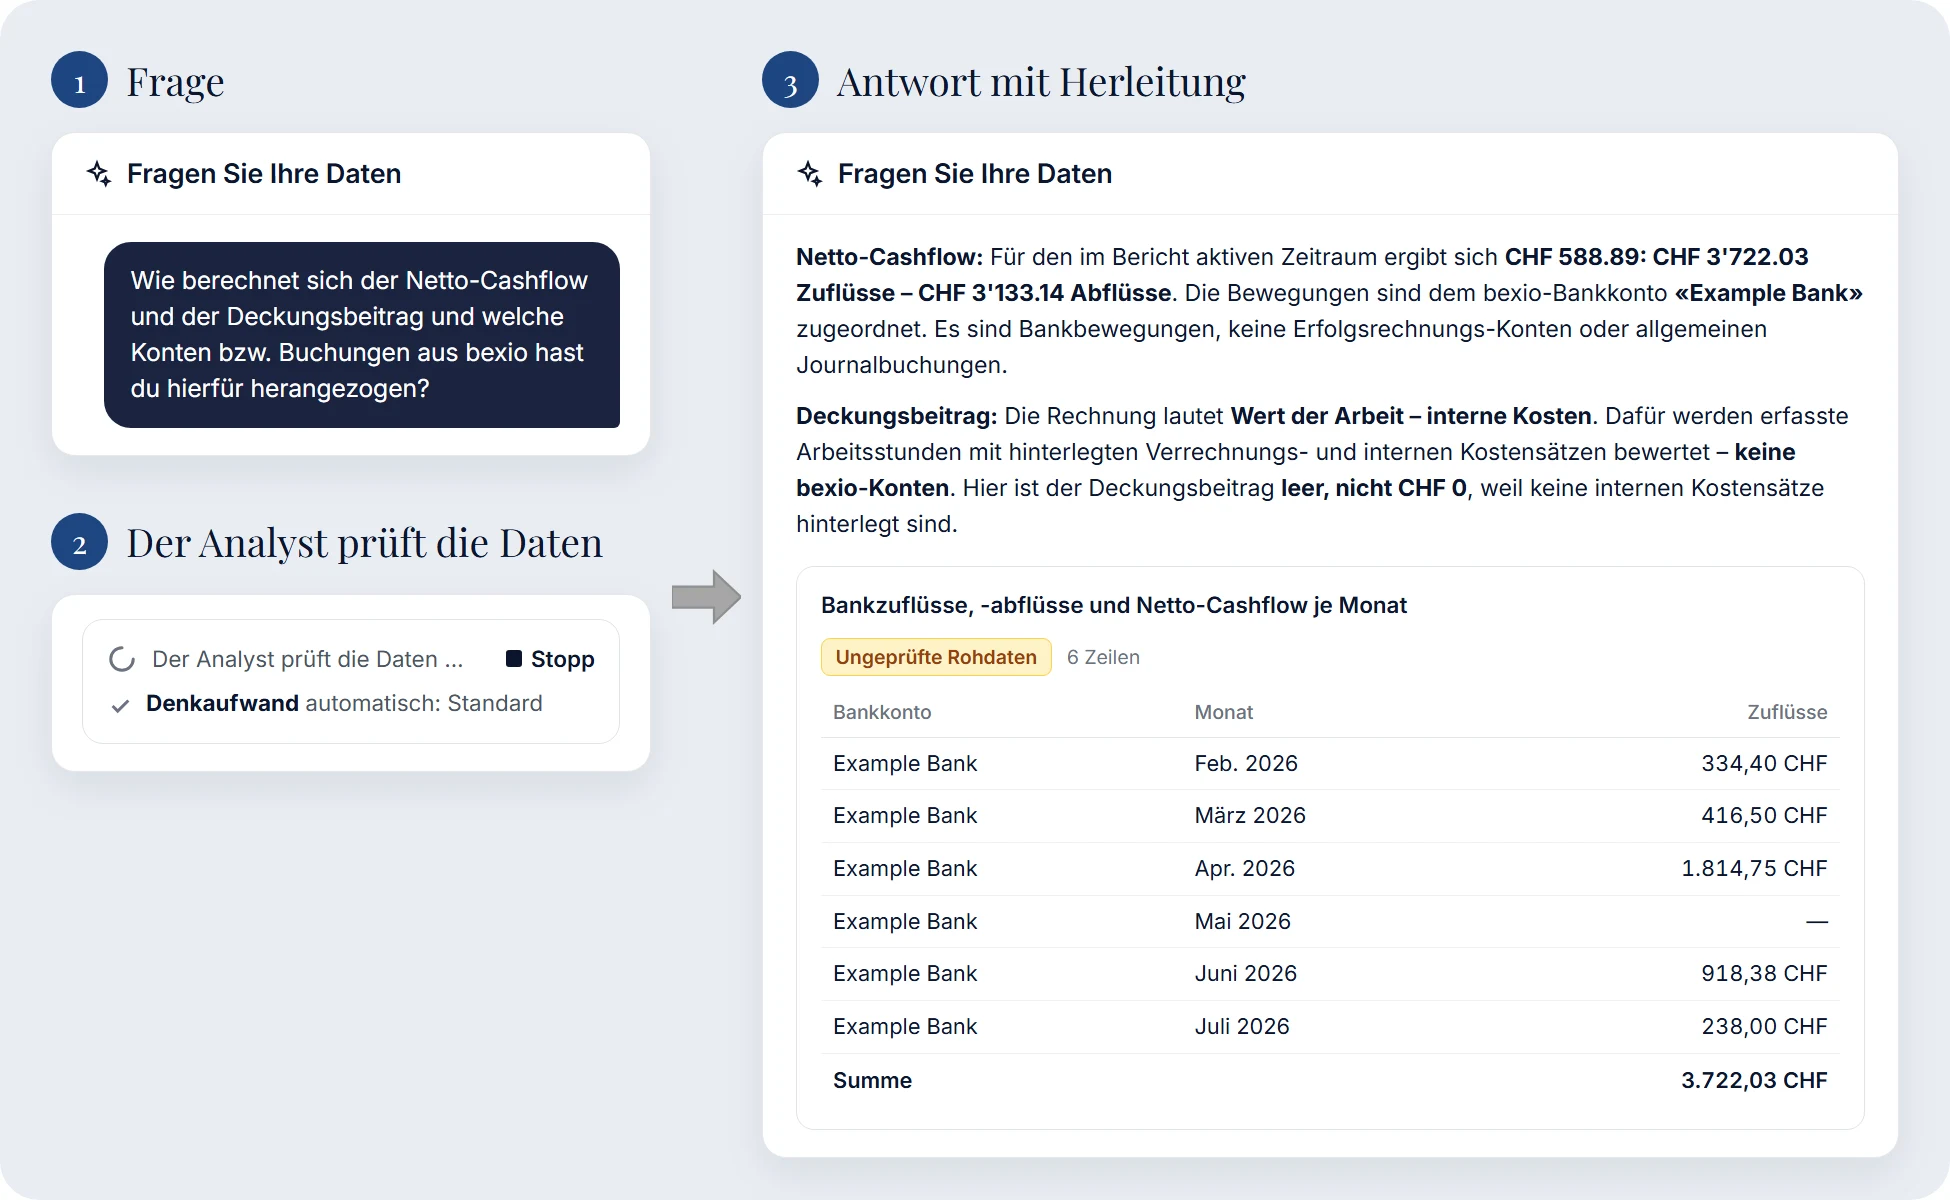
Warum diese Trennung? Die Forschung zu natürlichsprachlichen Datenbankabfragen zeigt, dass unternehmenstaugliche Text-zu-SQL-Übersetzung trotz großer Sprachmodelle noch nicht gelöst ist. Komplexe Schemata und mehrdeutige Begriffe führen zu Abfragen, die plausibel wirken, aber nicht das Gemeinte berechnen. „Umsatz“ ist in einer Buchhaltung eben keine Spalte, sondern eine Regel.[9]
Und jede Stelle, an der ein Sprachmodell Abfragen erzeugt, ist potenziell ein Angriffspunkt für Prompt Injection. Das Risiko führt die OWASP-Liste für LLM-Anwendungen an erster Stelle. Was im Bericht landet und geteilt wird, läuft deshalb immer über das geprüfte Modell. Freies Erkunden ist erlaubt, aber abgeschottet.[10]
Die KI-Nutzung ist pro Arbeitsbereich budgetiert und kann abgeschaltet werden.
Entwickeln mit KI-Agents: ein ehrlicher Erfahrungsbericht
smiit Analytics ist in rund drei Monaten entstanden. Die erste Zeile Code wurde Mitte Juni 2026 geschrieben, Mitte September waren Datenanbindung, Datenmodell, Berichtsumgebung, KI-Funktionen, Benutzerverwaltung und Betriebsoberfläche umgesetzt.
- ~3 Monatevon der ersten Zeile Code bis zur fertigen Plattform
- 4 SprachenDeutsch, Englisch, Französisch, Italienisch
- 22 Architekturentscheidungendokumentiert als Architecture Decision Records
- ~1.800 Testsautomatisiert, inklusive gezielter Isolationstests
Ohne KI-Coding-Agents wäre das in diesem Zeitraum nicht möglich gewesen. Die Geschwindigkeit ist aber nur ein Teil der Geschichte.
Was die Studienlage sagt
Die Forschung zeichnet kein eindeutiges Bild. In einem kontrollierten Experiment lösten Entwickler mit GitHub Copilot eine abgegrenzte Programmieraufgabe um 55,8 % schneller. Eine randomisierte Studie von METR mit erfahrenen Open-Source-Entwicklern in großen, gewachsenen Codebasen kam dagegen zu dem Ergebnis, dass KI-Werkzeuge die Bearbeitungszeit um 19 % verlängerten. Die Teilnehmenden selbst hatten eine Beschleunigung erwartet und auch im Nachhinein wahrgenommen. Der DORA-Report 2025 fasst die Lage so zusammen: KI wirkt als Verstärker. Starke Teams werden besser, bestehende Probleme werden größer.[11][12][13]
Unsere Erfahrung passt zu dieser Lesart, und sie erklärt, warum es bei uns funktioniert hat.
Was bei uns den Unterschied gemacht hat
- Architekturentscheidungen bleiben beim Menschen. Jede grundlegende Entscheidung, etwa zur Mandantentrennung, zum Ersatz von dbt oder zur Absicherung der KI-Funktionen, haben wir als Architecture Decision Record dokumentiert: Kontext, Optionen, Entscheidung, Konsequenzen. Die KI hat Optionen ausgearbeitet und Konsequenzen aufgezeigt. Entschieden haben wir. Diese Dokumente waren zugleich der wichtigste Kontext für die Agents, denn eine KI, die die Gründe einer Entscheidung kennt, hält sich deutlich zuverlässiger daran.[14]
- Tests sind die Leitplanken. Gerade bei Mandantentrennung und Kennzahlenlogik haben wir Regeln nicht nur beschrieben, sondern als Tests festgeschrieben. Eine Änderung, die eine Regel bricht, fällt sofort auf, egal ob sie von einem Menschen oder einer KI stammt.
- Systematische Review-Runden. In regelmäßigen Abständen haben wir den gesamten Stand gezielt auf Sicherheit, Performance und fachliche Korrektheit geprüft. Jeder Befund bekam eine Kennung, wurde behoben und mit einem Test abgesichert. Ein Großteil der oben beschriebenen „plausibel falschen“ Zahlen wurde in solchen Runden gefunden.
- Fachwissen ist nicht delegierbar. Dass bexio Eröffnungssalden jährlich neu bucht oder wie Treuhänder eine Bilanz gegliedert sehen wollen, weiß keine KI von allein. Die Erfahrung aus vier Jahren bexio-Projekten war die eigentliche Grundlage, auf der die Geschwindigkeit überhaupt sinnvoll nutzbar wurde.
Wo wir aufpassen mussten
Hohe Geschwindigkeit erzeugt auch schnell technische Schulden. Cunningham, der den Begriff geprägt hat, beschreibt schon 1992, dass etwas Schuld die Entwicklung beschleunigt, solange sie zeitnah zurückgezahlt wird. Mit KI-Agents gilt das verstärkt. Code entsteht schneller, als man ihn lesen kann. Lösungen sehen auf den ersten Blick vollständig aus, auch wenn ein Randfall fehlt. Und Dokumentation veraltet, wenn man sie nicht aktiv mitpflegt. Wir haben früh angefangen, Aufräumen als festen Teil jeder Phase einzuplanen, etwa beim Zusammenfassen von Datenbankmigrationen oder bei der Konsolidierung des semantischen Modells von 29 auf 9 zentrale Sichten.[15]
Unser Fazit zu diesem Punkt: KI-Agents haben uns nicht die Denkarbeit abgenommen, aber einen Großteil der Schreibarbeit. Wer klar weiß, was er bauen will, und die Qualität konsequent absichert, kann damit in Wochen umsetzen, wofür früher Monate nötig waren.
Was wir gelernt haben
- 1Das Geschäftsmodell ist Teil der ArchitekturUnser erstes Produkt ist nicht an der Technik gescheitert, sondern daran, dass sein Betriebsmodell kein faires Preismodell zuließ.
- 2Individualisierung muss skalierenEin Standardprodukt, bei dem jede Anpassung Entwicklungsaufwand bedeutet, ist ein Projektgeschäft mit anderem Etikett.
- 3Mandantentrennung gehört in die DatenbankAnwendungscode ist die erste Verteidigungslinie, aber nicht die letzte.
- 4Lieber ablehnen als falsch rechnenIn der Finanzanalyse ist eine Fehlermeldung besser als eine plausible, falsche Zahl.
- 5Standards sind Empfehlungen, keine Pflichtdbt ist ein hervorragendes Werkzeug, es passte nur nicht zu unserer zentralen Anforderung.
- 6KI braucht Leitplanken, im Produkt wie in der EntwicklungIn beiden Fällen gilt: klare Grenzen, nachvollziehbare Entscheidungen, Tests.
- 7Domänenwissen ist der eigentliche WettbewerbsvorteilCode lässt sich heute schnell schreiben. Zu wissen, welcher Code der richtige ist, lässt sich nicht beschleunigen.
Fazit und Ausblick
smiit Analytics ist das Ergebnis eines Umwegs, der sich gelohnt hat. Die Power-BI-Version hat uns gezeigt, was bexio-Kunden wirklich brauchen, und gleichzeitig, wie man es ihnen nicht verkaufen sollte. Die neue Plattform nimmt beides auf: Sie bildet den typischen Bedarf im Standard ab und ermöglicht individuelle Auswertungen, ohne dass dafür Entwicklungsaufwand entsteht.
smiit Analytics wird in Kürze über den bexio Marketplace verfügbar sein, als Abonnement pro verbundener bexio-Firma und Nutzer. Wir freuen uns darauf, die Plattform gemeinsam mit den ersten Kunden weiterzuentwickeln. Und wir sind ehrlich gesagt ein wenig stolz darauf, was in den letzten Monaten entstanden ist.